Prometheus چیست؟ Prometheus یک ابزار متن باز برای جمع آوری، ذخیره و تحلیل متریک های سری زمانی است که به تیم های فنی کمک می کند وضعیت سرورها، برنامه ها و سرویس ها را بررسی کرده و برای مشکلات احتمالی هشدار ایجاد کنند.
در زیرساخت های امروزی، مشاهده مداوم مصرف منابع، تعداد درخواست ها، زمان پاسخ و خطاهای سرویس ها اهمیت زیادی دارد. Prometheus این اطلاعات را در بازه های زمانی مشخص جمع آوری می کند و امکان جستجو و تحلیل آنها را با استفاده از زبان PromQL فراهم می سازد.
در ادامه این مقاله با نحوه کار Prometheus، معماری، اجزای اصلی، انواع متریک ها، سیستم هشداردهی و کاربرد آن در مانیتورینگ زیرساخت و Kubernetes آشنا می شویم.
خلاصه سریع: Prometheus چیست؟
Prometheus یک ابزار متن باز برای جمع آوری و تحلیل متریک های زیرساخت و برنامه ها است. این ابزار داده ها را به صورت سری زمانی ذخیره می کند، با زبان PromQL امکان تحلیل آنها را فراهم می سازد و با کمک Alertmanager برای مشکلاتی مانند افزایش مصرف منابع، کندی سرویس یا قطعی سرور هشدار ارسال می کند. Prometheus به ویژه برای مانیتورینگ محیط های ابری، کانتینرها و Kubernetes مناسب است.
Prometheus چیست؟
Prometheus یک ابزار متن باز برای مانیتورینگ و هشداردهی است که متریک های عددی مربوط به سرورها، برنامه ها، پایگاه های داده و سرویس ها را جمع آوری و به صورت داده های سری زمانی ذخیره می کند. تیم های فنی می توانند با تحلیل این داده ها، وضعیت زیرساخت را بررسی کرده و مشکلاتی مانند افزایش مصرف پردازنده، کمبود حافظه، کندی برنامه یا افزایش خطاها را سریع تر شناسایی کنند.
Prometheus معمولا در بازه های زمانی مشخص به سرویس ها و اجزای زیرساخت متصل می شود و متریک های آنها را دریافت می کند. این روش که با عنوان مدل Pull شناخته می شود، امکان مشاهده تغییرات شاخص های مختلف در طول زمان را فراهم می سازد. اطلاعات جمع آوری شده را نیز می توان با زبان اختصاصی PromQL جستجو، فیلتر و تحلیل کرد.
توسعه Prometheus در سال ۲۰۱۲ در شرکت SoundCloud آغاز شد. این پروژه بعدها به یک ابزار مستقل و متن باز تبدیل شد و در سال ۲۰۱۶ به عنوان دومین پروژه میزبانی شده پس از Kubernetes به بنیاد CNCF پیوست. امروزه Prometheus یکی از ابزارهای شناخته شده برای مانیتورینگ زیرساخت های ابری، معماری میکروسرویس و کلاسترهای Kubernetes محسوب می شود.
تفاوت Prometheus با ابزارهای مدیریت لاگ چیست؟
Prometheus در درجه اول برای جمع آوری و تحلیل متریک های عددی طراحی شده است؛ برای مثال میزان مصرف پردازنده، حافظه آزاد، تعداد درخواست ها، نرخ خطا و زمان پاسخ سرویس ها. در مقابل، ابزارهای مدیریت لاگ جزئیات رویدادها، پیام های خطا و فعالیت های ثبت شده توسط برنامه ها و سیستم عامل را جمع آوری و جستجو می کنند.
به زبان ساده، Prometheus نشان می دهد چه تغییری در وضعیت سیستم رخ داده است، در حالی که لاگ ها می توانند جزئیات بیشتری درباره دلیل وقوع آن تغییر ارائه دهند. به همین دلیل، مانیتورینگ متریک و مدیریت و تحلیل لاگ ها معمولا در کنار یکدیگر استفاده می شوند و جایگزین کامل یکدیگر نیستند.
Prometheus چگونه کار می کند؟
Prometheus با جمع آوری دوره ای متریک ها از سرورها، برنامه ها و سرویس ها، وضعیت زیرساخت را بررسی می کند. این ابزار داده های دریافت شده را به صورت سری زمانی ذخیره می کند تا بتوان تغییر شاخص هایی مانند مصرف پردازنده، میزان حافظه، تعداد درخواست ها، زمان پاسخ و نرخ خطا را در طول زمان مشاهده و تحلیل کرد.
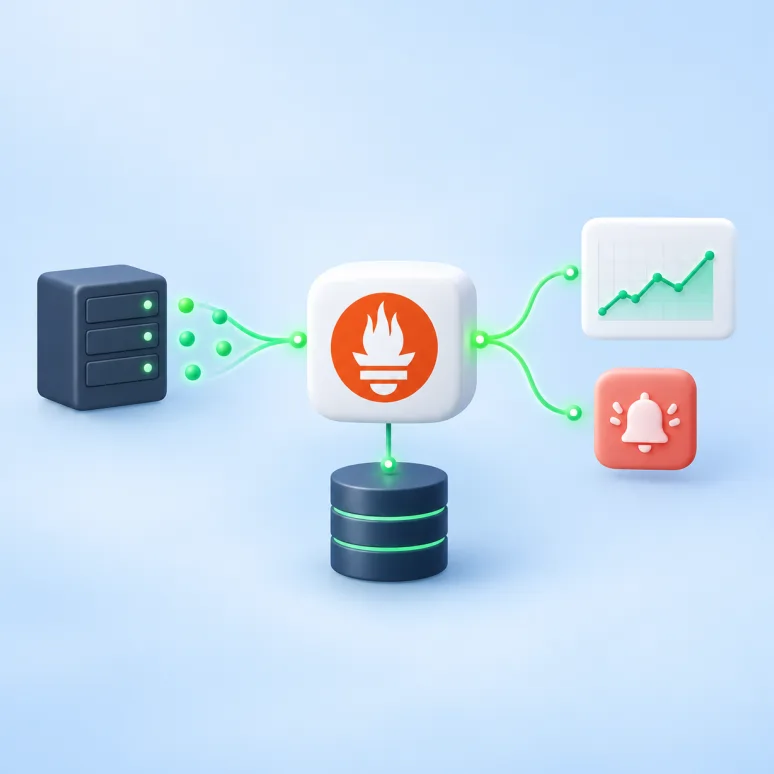
فرایند کار Prometheus را می توان در چند مرحله خلاصه کرد:
۱. شناسایی منابع جمع آوری متریک
Prometheus ابتدا باید بداند متریک ها را از چه سرورها یا سرویس هایی دریافت کند. این منابع که Target نامیده می شوند، می توانند به صورت دستی در فایل تنظیمات تعریف شوند یا از طریق Service Discovery به طور خودکار شناسایی شوند. قابلیت شناسایی خودکار به ویژه در محیط های پویا مانند Kubernetes اهمیت دارد؛ زیرا Podها و سرویس ها ممکن است دائما ایجاد، حذف یا جابه جا شوند.
۲. جمع آوری متریک ها با مدل Pull
Prometheus به طور پیش فرض از مدل Pull استفاده می کند. در این روش، خود Prometheus در بازه های زمانی مشخص به Targetها متصل می شود و متریک های جدید را دریافت می کند. این رفتار با بسیاری از ابزارهایی که داده ها را از سمت سرویس به سیستم مانیتورینگ ارسال می کنند، متفاوت است.
۳. خواندن متریک ها از Endpoint
هر سرویس یا Exporter، متریک های خود را از طریق یک Endpoint قابل دسترس ارائه می دهد. Prometheus با فرایندی به نام Scrape به این Endpoint مراجعه کرده و داده های موجود را دریافت می کند. فاصله زمانی انجام Scrape نیز از طریق تنظیمات Prometheus قابل تعیین است.
۴. ذخیره داده ها به صورت سری زمانی
متریک های جمع آوری شده همراه با زمان ثبت و Labelهای مرتبط در پایگاه داده سری زمانی Prometheus ذخیره می شوند. Labelها اطلاعات تکمیلی مانند نام سرویس، سرور، محیط یا وضعیت درخواست را مشخص می کنند و امکان فیلتر و دسته بندی دقیق داده ها را فراهم می سازند.
۵. جستجو و تحلیل داده ها
کاربران می توانند با استفاده از زبان PromQL روی متریک های ذخیره شده Query اجرا کنند. برای مثال، می توان میانگین مصرف پردازنده در پنج دقیقه گذشته، نرخ خطای یک سرویس یا تعداد درخواست های ورودی را محاسبه کرد. نتایج این Queryها در محیط Prometheus قابل مشاهده هستند یا برای ساخت داشبورد به ابزارهایی مانند Grafana ارسال می شوند.
۶. بررسی قوانین و ایجاد هشدار
Prometheus به صورت دوره ای قوانین هشدار را بررسی می کند. اگر نتیجه یک Query با شرایط تعریف شده مطابقت داشته باشد، Prometheus یک هشدار ایجاد کرده و آن را برای Alertmanager ارسال می کند. Alertmanager هشدارها را گروه بندی و مدیریت می کند و سپس اعلان مناسب را از طریق کانال هایی مانند ایمیل یا پیام رسان ارسال می کند.
به زبان ساده، Prometheus متریک ها را جمع آوری و ذخیره می کند، آنها را با PromQL تحلیل می کند و در صورت مشاهده شرایط غیرعادی هشدار می دهد. این فرایند به تیم های فنی کمک می کند مشکلات زیرساخت را پیش از تبدیل شدن به اختلال جدی شناسایی کنند.
معماری Prometheus از چه اجزایی تشکیل شده است؟
معماری Prometheus از چند جزء اصلی برای جمع آوری، ذخیره، تحلیل و نمایش متریک ها تشکیل شده است. در این معماری، سرور Prometheus نقش مرکزی را دارد، Exporterها متریک ها را ارائه می دهند، Alertmanager هشدارها را مدیریت می کند و ابزارهایی مانند Grafana برای نمایش داده ها به کار می روند.
به زبان ساده، جریان داده در معماری Prometheus به این صورت است:
۱. Target یا Exporter متریک ها را ارائه می دهد.
۲. سرور Prometheus متریک ها را جمع آوری و ذخیره می کند.
۳. PromQL برای جستجو و تحلیل متریک ها استفاده می شود.
۴. Grafana داده ها را از Prometheus دریافت و نمایش می دهد.
۵. هشدارهای ایجاد شده توسط Prometheus برای Alertmanager ارسال می شوند.
سرور Prometheus
سرور Prometheus بخش اصلی این سیستم مانیتورینگ است. این سرور در بازه های زمانی مشخص به Targetها متصل می شود، متریک ها را از Endpointهای تعریف شده جمع آوری می کند و آنها را در پایگاه داده سری زمانی داخلی خود ذخیره می سازد.
سرور Prometheus همچنین وظیفه اجرای Queryهای نوشته شده با PromQL و بررسی قوانین هشدار را بر عهده دارد. کاربران و ابزارهای دیگر نیز می توانند از طریق رابط وب یا API به داده های ذخیره شده دسترسی پیدا کنند.
Exporterها
Exporter یک ابزار واسط است که اطلاعات یک سیستم یا سرویس را جمع آوری کرده و آنها را با قالب قابل خواندن برای Prometheus ارائه می دهد. Exporterها معمولا زمانی استفاده می شوند که یک سرور، پایگاه داده یا نرم افزار به صورت مستقیم متریک های Prometheus را تولید نمی کند.
برای مثال، Node Exporter متریک هایی مانند مصرف پردازنده، حافظه، فضای دیسک و ترافیک شبکه سرورهای لینوکسی را ارائه می دهد. Exporterهای دیگری نیز برای پایگاه های داده، تجهیزات شبکه، وب سرورها و سرویس های مختلف وجود دارند.
Client Libraryها
Client Libraryها به توسعه دهندگان اجازه می دهند متریک های اختصاصی را مستقیما در کد برنامه ایجاد کنند. با استفاده از این کتابخانه ها می توان شاخص هایی مانند تعداد درخواست ها، زمان پاسخ، تعداد خطاها یا مدت اجرای یک فرایند را اندازه گیری کرد.
Prometheus برای زبان های برنامه نویسی مختلف کتابخانه ارائه می دهد. برنامه پس از تعریف متریک ها، آنها را از طریق یک Endpoint در اختیار سرور Prometheus قرار می دهد.
Pushgateway
Prometheus معمولا متریک ها را با مدل Pull دریافت می کند، اما برخی فرایندهای کوتاه مدت ممکن است پیش از مراجعه Prometheus پایان پیدا کنند. Pushgateway برای دریافت متریک های چنین فرایندهایی طراحی شده است.
در این روش، فرایند کوتاه مدت متریک های خود را به Pushgateway ارسال می کند و Prometheus بعدا آنها را از Pushgateway دریافت می کند. این ابزار بیشتر برای Batch Jobهای کوتاه مدت مناسب است و نباید به عنوان جایگزین عمومی مدل Pull استفاده شود.
Alertmanager
Prometheus معمولا متریک ها را با مدل Pull دریافت می کند، اما برخی فرایندهای کوتاه مدت ممکن است پیش از مراجعه Prometheus پایان پیدا کنند. Pushgateway برای دریافت متریک های چنین فرایندهایی طراحی شده است.
در این روش، فرایند کوتاه مدت متریک های خود را به Pushgateway ارسال می کند و Prometheus بعدا آنها را از Pushgateway دریافت می کند. این ابزار بیشتر برای Batch Jobهای کوتاه مدت مناسب است و نباید به عنوان جایگزین عمومی مدل Pull استفاده شود.
Alertmanager
سرور Prometheus قوانین هشدار را بررسی می کند و در صورت برقرار شدن شرایط تعریف شده، هشدار را برای Alertmanager می فرستد. Alertmanager وظیفه گروه بندی، حذف هشدارهای تکراری، بی صدا کردن هشدارها و ارسال اعلان به کانال های تعیین شده را بر عهده دارد.
برای مثال، اگر مصرف پردازنده یک سرور برای مدت مشخصی بیشتر از حد مجاز باشد، Prometheus هشدار را ایجاد می کند و Alertmanager آن را از طریق ایمیل یا پیام رسان به تیم فنی اطلاع می دهد.
Service Discovery
Service Discovery به Prometheus کمک می کند سرورها و سرویس های قابل مانیتورینگ را به صورت خودکار شناسایی کند. این قابلیت در زیرساخت های پویا اهمیت زیادی دارد؛ زیرا آدرس و تعداد سرویس ها ممکن است دائما تغییر کند.
برای مثال، در Kubernetes ممکن است Podها حذف و دوباره ایجاد شوند. Prometheus با استفاده از Service Discovery می تواند Targetهای جدید را شناسایی کند و جمع آوری متریک ها را بدون تعریف دستی هر Pod ادامه دهد
ابزارهای نمایش داده مانند Grafana
Prometheus یک رابط ساده برای مشاهده و جستجوی متریک ها دارد، اما برای ساخت داشبوردهای حرفه ای معمولا در کنار Grafana استفاده می شود. Grafana به Prometheus متصل می شود و داده های آن را در قالب نمودار، جدول و داشبوردهای قابل تنظیم نمایش می دهد.
در این ترکیب، Prometheus مسئول جمع آوری و ذخیره متریک ها است و Grafana وظیفه نمایش تصویری داده ها را بر عهده دارد. بنابراین Prometheus و Grafana جایگزین یکدیگر نیستند، بلکه دو ابزار مکمل در سیستم مانیتورینگ زیرساخت محسوب می شوند.
متریک و داده سری زمانی در Prometheus چیست؟
Prometheus اطلاعات مربوط به وضعیت سرورها، برنامه ها و سرویس ها را در قالب متریک های سری زمانی ذخیره می کند. هر متریک یک مقدار عددی است که در زمان های مختلف ثبت می شود و تغییرات یک شاخص مشخص مانند مصرف پردازنده، میزان حافظه، تعداد درخواست ها یا زمان پاسخ را نشان می دهد.
در مدل داده Prometheus، هر سری زمانی با نام متریک و مجموعه ای از Labelها شناسایی می شود. هر نمونه ذخیره شده نیز شامل یک مقدار عددی و زمان ثبت آن است.
Metric چیست؟
Metric یا متریک یک مقدار عددی قابل اندازه گیری است که وضعیت یا عملکرد بخشی از سیستم را نشان می دهد. Prometheus این مقادیر را در بازه های زمانی مشخص جمع آوری می کند تا امکان بررسی تغییرات آنها فراهم شود.
نمونه هایی از متریک های قابل جمع آوری عبارتند از:
- میزان مصرف پردازنده
- مقدار حافظه استفاده شده
- فضای باقی مانده دیسک
- تعداد درخواست های دریافتی
- تعداد خطاهای برنامه
- زمان پاسخ یک سرویس
- تعداد کاربران فعال
- تعداد اتصال های پایگاه داده
برای مثال، متریکی با نام زیر می تواند تعداد کل درخواست های دریافت شده توسط یک سرور را نشان دهد:
http_requests_totalنام متریک باید مشخص کند چه چیزی اندازه گیری می شود. انتخاب نام های واضح و ثابت، جستجو و تحلیل داده ها را در Prometheus ساده تر می کند.
Time Series چیست؟
Time Series یا داده سری زمانی، مجموعه ای از مقادیر ثبت شده برای یک متریک در زمان های مختلف است. این داده ها نشان می دهند یک شاخص در طول زمان چگونه تغییر کرده است.
برای مثال، اگر میزان مصرف پردازنده هر ۱۵ ثانیه ثبت شود، مجموعه مقادیر ذخیره شده یک سری زمانی را تشکیل می دهد. با بررسی این داده ها می توان افزایش ناگهانی مصرف منابع، کاهش عملکرد یا الگوهای تکرارشونده را شناسایی کرد.
هر نمونه در یک سری زمانی Prometheus شامل دو بخش اصلی است:
- مقدار عددی متریک
- زمان ثبت مقدار
Prometheus می تواند از این اطلاعات برای رسم نمودار، مقایسه بازه های زمانی، اجرای Query و بررسی قوانین هشدار استفاده کند.
Label در Prometheus چیست؟
Label یک جفت کلید و مقدار است که اطلاعات بیشتری درباره یک متریک ارائه می دهد. Labelها امکان فیلتر، گروه بندی و مقایسه متریک ها را بدون نیاز به ایجاد نام های متعدد فراهم می کنند.
برای مثال، متریک تعداد درخواست ها می تواند Labelهایی برای روش درخواست، مسیر API و وضعیت پاسخ داشته باشد:
http_requests_total{method="GET", status="200"}در این مثال:
http_requests_totalنام متریک است.methodوstatusنام Labelها هستند.GETو200مقادیر Labelها هستند.
هر ترکیب متفاوت از نام متریک و Labelها، یک سری زمانی مستقل ایجاد می کند. برای مثال، درخواست های GET با وضعیت 200 و درخواست های POST با وضعیت 500 در دو سری زمانی جداگانه ذخیره می شوند.
تعداد Labelها و مقادیر آنها باید با دقت کنترل شود. استفاده از مقادیر بسیار متنوع مانند شناسه هر کاربر یا شماره هر درخواست می تواند تعداد سری های زمانی را به شدت افزایش دهد و مصرف حافظه و فضای ذخیره سازی Prometheus را بالا ببرد.
نمونه ساده یک متریک در Prometheus
فرض کنیم یک فروشگاه اینترنتی می خواهد تعداد درخواست های دریافت شده توسط API را بررسی کند. متریک مورد نظر می تواند به شکل زیر باشد:
api_requests_total{method="GET", endpoint="/products", status="200"} 1250اجزای این متریک عبارتند از:
api_requests_total: نام متریکmethod="GET": روش ارسال درخواستendpoint="/products": مسیر درخواستstatus="200": وضعیت پاسخ1250: مقدار فعلی متریک
این داده نشان می دهد API محصولات تا زمان ثبت این نمونه، ۱۲۵۰ درخواست موفق از نوع GET دریافت کرده است. Prometheus با ثبت این مقدار در زمان های مختلف می تواند نرخ افزایش درخواست ها را محاسبه کند.
به زبان ساده، متریک مشخص می کند چه چیزی اندازه گیری می شود، Labelها جزئیات آن را توضیح می دهند و داده سری زمانی تغییر مقدار متریک را در طول زمان نشان می دهد. این ساختار پایه اصلی ذخیره سازی و تحلیل اطلاعات در Prometheus است.
انواع متریک در Prometheus
Prometheus برای اندازه گیری داده های مختلف از چهار نوع اصلی متریک شامل Counter، Gauge، Histogram و Summary استفاده می کند. انتخاب نوع مناسب متریک اهمیت زیادی دارد؛ زیرا هرکدام رفتار متفاوتی دارند و برای تحلیل نوع خاصی از داده ها طراحی شده اند.
به طور خلاصه، Counter برای شمارش مقادیر افزایشی، Gauge برای مقادیر متغیر، Histogram برای گروه بندی مشاهدات در بازه های مشخص و Summary برای محاسبه صدک ها استفاده می شود.
Metric چیست؟
Counter یک متریک شمارنده است که مقدار آن فقط افزایش پیدا می کند یا در صورت راه اندازی مجدد سرویس به صفر باز می گردد. از Counter برای اندازه گیری مقادیری استفاده می شود که در طول زمان انباشته می شوند.
کاربردهای متداول Counter عبارتند از:
- تعداد کل درخواست های دریافت شده
- تعداد خطاهای برنامه
- تعداد عملیات انجام شده
- تعداد ورودهای موفق
- تعداد وظایف پردازش شده
برای مثال، متریک زیر نشان می دهد API محصولات تاکنون ۱۲۵۰ درخواست موفق از نوع GET دریافت کرده است:
api_requests_total{method="GET", endpoint="/products", status="200"} 1250Counter برای مقادیری مانند دمای سرور یا میزان حافظه مناسب نیست؛ زیرا این مقادیر ممکن است هم افزایش و هم کاهش پیدا کنند.
Gauge چیست؟
Gauge متریکی است که مقدار آن می تواند افزایش یا کاهش پیدا کند. این نوع متریک برای اندازه گیری وضعیت فعلی یک منبع یا سرویس استفاده می شود.
نمونه های رایج Gauge عبارتند از:
- میزان مصرف حافظه
- دمای پردازنده
- تعداد اتصال های فعال
- تعداد درخواست های در حال پردازش
- فضای باقی مانده دیسک
- طول صف پردازش
در نمونه زیر، مقدار متریک نشان می دهد ۲۵۶ اتصال در حال حاضر فعال هستند:
active_connections 256برخلاف Counter، کاهش مقدار Gauge طبیعی است. برای مثال، با بسته شدن اتصال ها، مقدار active_connections کاهش پیدا می کند.
Histogram چیست؟
Histogram برای اندازه گیری و گروه بندی مقادیری مانند زمان پاسخ، حجم درخواست یا مدت اجرای یک عملیات استفاده می شود. این متریک مشاهدات را در بازه هایی به نام Bucket قرار می دهد.
Histogram معمولا سه نوع داده تولید می کند:
- تعداد مشاهدات قرار گرفته در هر Bucket
- تعداد کل مشاهدات با پسوند
_count - مجموع مقادیر ثبت شده با پسوند
_sum
در نمونه زیر، مقدار متریک نشان می دهد ۱۸۴۲ درخواست در مدت زمان کمتر یا مساوی با نیم ثانیه پاسخ داده شده اند:
http_request_duration_seconds_bucket{le="0.5"} 1842مقدار le="0.5" به معنای کمتر یا مساوی با ۰.۵ ثانیه است. با استفاده از داده های Histogram می توان توزیع زمان پاسخ و صدک هایی مانند صدک ۹۵ را در سمت سرور Prometheus محاسبه کرد.
Summary چیست؟
Summary نیز برای اندازه گیری مقادیری مانند زمان پاسخ و مدت اجرای عملیات استفاده می شود، اما برخلاف Histogram می تواند صدک ها را در سمت برنامه محاسبه کند.
برای مثال، صدک ۹۵ زمان پاسخ نشان می دهد ۹۵ درصد درخواست ها در زمانی کمتر یا مساوی با مقدار ثبت شده پاسخ داده شده اند:
http_request_duration_seconds{quantile="0.95"} 0.42این نمونه نشان می دهد ۹۵ درصد درخواست های بررسی شده در حدود ۰.۴۲ ثانیه یا کمتر پاسخ داده شده اند. Summary نیز مانند Histogram مقدارهای _sum و _count را تولید می کند.
تفاوت اصلی این است که Histogram داده ها را در Bucketها ثبت می کند و امکان محاسبه صدک ها در Prometheus را می دهد، اما Summary صدک ها را از قبل در برنامه محاسبه می کند. به همین دلیل، Histogram معمولا برای تجمیع داده های چند سرور انعطاف پذیری بیشتری دارد.
PromQL چیست و چه کاربردی دارد؟
PromQL مخفف Prometheus Query Language و زبان جستجو و تحلیل داده ها در Prometheus است. با استفاده از PromQL می توان متریک های ذخیره شده را انتخاب، فیلتر، محاسبه، گروه بندی و تجمیع کرد. نتیجه Queryها نیز می تواند در رابط Prometheus، داشبوردهای Grafana یا قوانین هشدار استفاده شود.
PromQL برخلاف SQL برای جستجو در جداول پایگاه داده طراحی نشده است. این زبان روی داده های سری زمانی کار می کند و امکان بررسی تغییر متریک ها در یک لحظه یا بازه زمانی مشخص را فراهم می سازد.
فیلتر کردن متریک ها
در PromQL می توان یک متریک را با استفاده از نام آن انتخاب کرد و سپس نتایج را براساس Labelها محدود ساخت. Query زیر فقط درخواست های متد GET با وضعیت ۲۰۰ را نمایش می دهد:
http_requests_total{method="GET", status="200"}در این Query، http_requests_total نام متریک است و مقادیر داخل آکولاد شرایط فیلتر را مشخص می کنند. با این روش می توان داده های مربوط به یک سرور، سرویس، مسیر یا وضعیت مشخص را جداگانه بررسی کرد.
محاسبه نرخ تغییر
متریک های Counter به طور مداوم افزایش پیدا می کنند و مشاهده مقدار کل آنها همیشه برای تحلیل عملکرد مفید نیست. تابع rate() میانگین نرخ افزایش یک Counter را در یک بازه زمانی محاسبه می کند.
Query زیر نرخ متوسط درخواست های HTTP را در پنج دقیقه گذشته محاسبه می کند:
rate(http_requests_total[5m])عبارت [5m] بازه پنج دقیقه ای را مشخص می کند. نتیجه تابع rate() نرخ متوسط افزایش متریک در هر ثانیه است. این تابع تغییرات ناشی از صفر شدن Counter پس از راه اندازی مجدد سرویس را نیز در محاسبه در نظر می گیرد.
گروه بندی و تجمیع داده ها
PromQL توابع و عملگرهایی مانند sum، avg، min و max را برای تجمیع متریک ها ارائه می دهد. همچنین می توان نتایج را براساس Labelهای مشخص گروه بندی کرد.
برای مثال، Query زیر نرخ درخواست ها را در پنج دقیقه گذشته محاسبه کرده و نتیجه را براساس کد وضعیت پاسخ گروه بندی می کند:
sum by (status) (rate(http_requests_total[5m]))با نتیجه این Query می توان تعداد درخواست های موفق و ناموفق را براساس کدهای وضعیت مقایسه کرد. همین داده می تواند برای ساخت نمودار در Grafana یا ایجاد هشدار هنگام افزایش خطاهای سرور استفاده شود.
به طور خلاصه، PromQL ابزار اصلی Prometheus برای تبدیل متریک های خام به اطلاعات قابل تحلیل است. فیلتر کردن داده ها، محاسبه نرخ تغییر، مقایسه بازه های زمانی، گروه بندی متریک ها و تعریف شرایط هشدار از مهم ترین کاربردهای این زبان هستند.
Exporter در Prometheus چیست؟
Exporter در Prometheus یک ابزار واسط است که اطلاعات مربوط به یک سیستم، سرویس یا نرم افزار را جمع آوری کرده و آنها را به متریک های قابل خواندن برای Prometheus تبدیل می کند. Prometheus در بازه های زمانی مشخص به Endpoint مربوط به Exporter متصل می شود و متریک های آماده شده را با فرایند Scrape دریافت می کند.
Exporterها معمولا زمانی استفاده می شوند که یک سیستم به صورت پیش فرض متریک هایی با قالب Prometheus ارائه نمی دهد. برای مثال، سیستم عامل لینوکس، پایگاه داده یا تجهیزات شبکه اطلاعات مورد نیاز را در اختیار Exporter قرار می دهند و Exporter این اطلاعات را به قالب استاندارد قابل پردازش برای Prometheus تبدیل می کند.
به زبان ساده، Exporter اطلاعات یک سیستم را دریافت و آن را به زبانی تبدیل می کند که Prometheus قادر به جمع آوری و تحلیل آن باشد.
Node Exporter چیست؟
Node Exporter یکی از شناخته شده ترین Exporterهای Prometheus برای مانیتورینگ سرورهای لینوکسی است. این ابزار روی سرور نصب می شود و متریک های مربوط به سیستم عامل و منابع سخت افزاری را در اختیار Prometheus قرار می دهد.
Node Exporter می تواند اطلاعاتی مانند موارد زیر را جمع آوری کند:
- میزان مصرف پردازنده
- مقدار حافظه آزاد و استفاده شده
- فضای دیسک و وضعیت فایل سیستم
- ترافیک ورودی و خروجی شبکه
- میزان بار سیستم
- تعداد فرایندها
- زمان روشن بودن سرور
Node Exporter وضعیت برنامه های در حال اجرا را به صورت تخصصی بررسی نمی کند و تمرکز اصلی آن روی منابع و وضعیت سیستم عامل است. برای مانیتورینگ برنامه ها یا پایگاه های داده باید از متریک های داخلی آنها یا Exporterهای مخصوص استفاده شود.
Blackbox Exporter چیست؟
Blackbox Exporter برای بررسی دسترسی پذیری و عملکرد سرویس ها از دید بیرونی استفاده می شود. این ابزار بدون نیاز به دسترسی مستقیم به اجزای داخلی برنامه، یک سرویس را مانند یک کاربر یا سیستم خارجی آزمایش می کند.
Blackbox Exporter از پروتکل هایی مانند HTTP، HTTPS، DNS، TCP و ICMP پشتیبانی می کند و می تواند موارد زیر را بررسی کند:
- در دسترس بودن وب سایت
- مدت زمان پاسخ HTTP
- اعتبار و تاریخ انقضای گواهی SSL
- پاسخ گویی DNS
- باز بودن پورت TCP
- دسترسی شبکه با استفاده از ICMP
برای مثال، اگر هدف بررسی شود که یک وب سایت از اینترنت در دسترس است یا گواهی SSL آن چه زمانی منقضی می شود، Blackbox Exporter گزینه مناسبی خواهد بود.
Exporter پایگاه داده چیست؟
Exporterهای پایگاه داده، اطلاعات مربوط به عملکرد و وضعیت پایگاه های داده را به متریک های قابل استفاده در Prometheus تبدیل می کنند. برای هر نوع پایگاه داده معمولا Exporter مخصوصی وجود دارد؛ مانند MySQL Exporter، PostgreSQL Exporter و MongoDB Exporter.
این Exporterها می توانند متریک هایی مانند موارد زیر را ارائه دهند:
- تعداد اتصال های فعال
- تعداد Queryهای اجرا شده
- مدت زمان اجرای Queryها
- تعداد تراکنش ها
- میزان استفاده از حافظه
- تعداد خطاهای اتصال
- وضعیت Replication
- قفل ها و Queryهای در انتظار
مانیتورینگ این شاخص ها به تیم فنی کمک می کند کاهش عملکرد، افزایش اتصال ها یا ایجاد اختلال در پایگاه داده را پیش از تاثیر جدی بر کاربران شناسایی کند.
Exporter اختصاصی برنامه چیست؟
اگر یک برنامه یا سرویس Exporter آماده نداشته باشد، می توان برای آن یک Exporter اختصاصی ایجاد کرد. Exporter اختصاصی اطلاعات مورد نیاز را از API، فایل، دستورهای سیستم یا سایر منابع دریافت کرده و آنها را از طریق یک Endpoint با قالب Prometheus ارائه می دهد.
برای مثال، یک Exporter اختصاصی می تواند اطلاعاتی مانند تعداد سفارش های در انتظار، مدت اجرای یک فرایند، وضعیت یک دستگاه یا تعداد وظایف ناموفق را جمع آوری کند.
البته اگر امکان تغییر کد برنامه وجود داشته باشد، معمولا استفاده از Client Library و تعریف مستقیم متریک ها در داخل برنامه انتخاب مناسب تری است. Exporter اختصاصی بیشتر زمانی کاربرد دارد که امکان تغییر نرم افزار اصلی وجود ندارد یا اطلاعات مورد نیاز باید از یک سیستم قدیمی دریافت شود.
در مجموع، انتخاب Exporter به نوع منبعی بستگی دارد که باید مانیتور شود. Node Exporter برای سرور لینوکسی، Blackbox Exporter برای بررسی دسترسی بیرونی، Exporter پایگاه داده برای عملکرد دیتابیس و Exporter اختصاصی برای سیستم های فاقد پشتیبانی مستقیم استفاده می شود.
Alertmanager چیست و چگونه هشدارها را مدیریت می کند؟
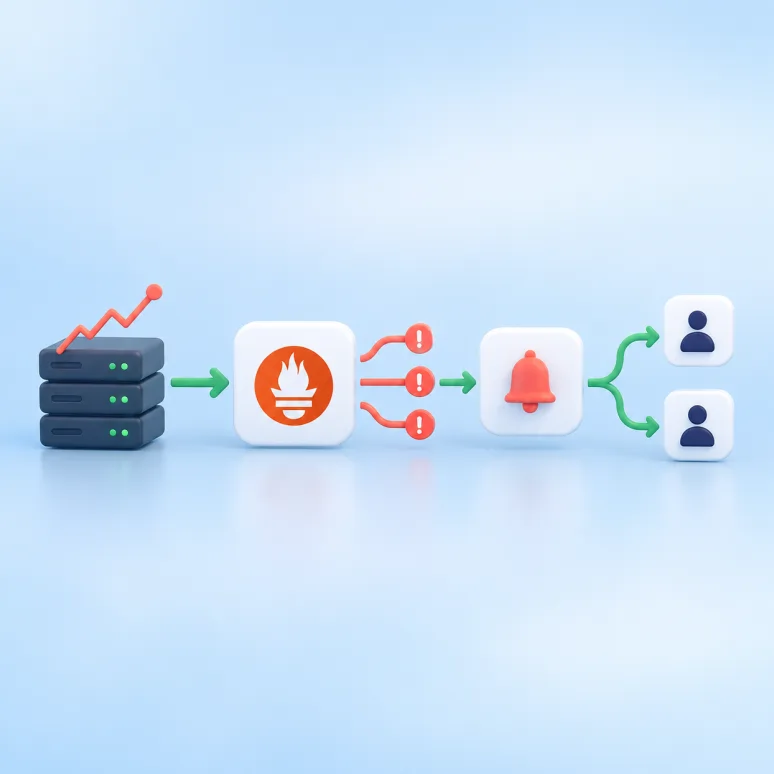
Alertmanager یکی از اجزای اکوسیستم Prometheus است که وظیفه دریافت، گروه بندی، حذف موارد تکراری و ارسال هشدارها به افراد یا تیم های مسئول را بر عهده دارد. Prometheus شرایط غیرعادی را با استفاده از قوانین هشدار شناسایی می کند و هشدارهای ایجاد شده را برای Alertmanager می فرستد.
برای مثال، می توان قانونی تعریف کرد که اگر مصرف پردازنده یک سرور برای پنج دقیقه بیشتر از ۹۰ درصد باقی ماند، هشدار ایجاد شود. Prometheus این شرط را بررسی می کند و در صورت برقرار بودن آن، اطلاعات هشدار را به Alertmanager ارسال می کند. سپس Alertmanager براساس تنظیمات مشخص می کند هشدار از چه مسیری و برای چه فرد یا تیمی فرستاده شود.
فرایند مدیریت هشدارها در Alertmanager شامل مراحل زیر است:
۱. دریافت هشدار از Prometheus
Prometheus قوانین هشدار را به صورت دوره ای ارزیابی می کند. اگر نتیجه یک Query با شرایط تعریف شده مطابقت داشته باشد، هشدار فعال شده و برای Alertmanager ارسال می شود.
اطلاعات هر هشدار می تواند شامل نام هشدار، شدت، نام سرویس، سرور مربوط، زمان شروع و توضیح مشکل باشد. Alertmanager از Labelهای این هشدارها برای دسته بندی و مسیریابی آنها استفاده می کند.
۲. گروه بندی هشدارهای مرتبط
در زمان بروز یک اختلال، ممکن است تعداد زیادی هشدار مرتبط به طور همزمان ایجاد شود. برای مثال، از دسترس خارج شدن یک سرور می تواند برای چندین سرویس و متریک هشدار ایجاد کند.
Alertmanager می تواند این هشدارهای مرتبط را براساس Labelهایی مانند نام سرویس، محیط یا کلاستر گروه بندی کند و آنها را در قالب یک اعلان ارسال کند. این قابلیت از ارسال تعداد زیادی پیام جداگانه جلوگیری کرده و بررسی مشکل اصلی را ساده تر می سازد.
۳. حذف هشدارهای تکراری
Prometheus تا زمانی که یک مشکل ادامه داشته باشد، وضعیت هشدار را برای Alertmanager ارسال می کند. Alertmanager هشدارهای تکراری را شناسایی می کند و مانع ارسال مداوم اعلان های یکسان می شود.
این فرایند که Deduplication نام دارد، تعداد اعلان های غیرضروری را کاهش می دهد. با این حال، می توان تنظیم کرد که اگر مشکل برای مدت طولانی ادامه داشت، یادآوری دیگری ارسال شود.
۴. بی صدا کردن یا مهار هشدارها
Alertmanager امکان بی صدا کردن موقت هشدارها را با استفاده از Silence فراهم می کند. این قابلیت هنگام تعمیرات برنامه ریزی شده، به روزرسانی سرور یا آزمایش زیرساخت کاربرد دارد.
قابلیت Inhibition نیز می تواند هشدارهای فرعی را در صورت فعال بودن یک هشدار اصلی مهار کند. برای مثال، اگر یک سرور به طور کامل از دسترس خارج شده باشد، ارسال هشدارهای جداگانه برای تمام سرویس های همان سرور ممکن است ضروری نباشد.
۵. مسیریابی و ارسال اعلان
Alertmanager می تواند هشدارها را براساس نوع، شدت، سرویس یا محیط به مقصدهای متفاوت ارسال کند. برای مثال، هشدارهای بحرانی برای تیم عملیات و هشدارهای کم اهمیت برای ایمیل عمومی تیم ارسال می شوند.
اعلان ها می توانند از طریق مسیرهایی مانند ایمیل، Webhook یا سامانه های مدیریت رخداد ارسال شوند. همچنین با استفاده از Webhook می توان Alertmanager را به پیام رسان ها یا ابزارهای اختصاصی سازمان متصل کرد.
تفاوت Prometheus و Alertmanager
Prometheus و Alertmanager وظایف متفاوت اما مرتبطی دارند:
- Prometheus متریک ها را جمع آوری و ذخیره می کند، Queryها را اجرا می کند و شرایط هشدار را تشخیص می دهد.
- Alertmanager هشدارهای ایجاد شده را دریافت، گروه بندی، مسیریابی و ارسال می کند.
به زبان ساده، Prometheus تشخیص می دهد چه زمانی مشکلی رخ داده است و Alertmanager مشخص می کند هشدار آن مشکل چگونه و برای چه کسی ارسال شود. استفاده همزمان از این دو ابزار، فرایند شناسایی و اطلاع رسانی مشکلات زیرساخت را منظم تر و قابل کنترل تر می کند.
ارتباط Prometheus و Grafana چیست؟
Prometheus و Grafana دو ابزار مکمل برای مانیتورینگ و مشاهده وضعیت زیرساخت هستند. Prometheus متریک ها را جمع آوری و ذخیره می کند، در حالی که Grafana این داده ها را در قالب نمودارها و داشبوردهای قابل فهم نمایش می دهد. این دو ابزار رقیب یکدیگر نیستند و معمولا در کنار هم استفاده می شوند.
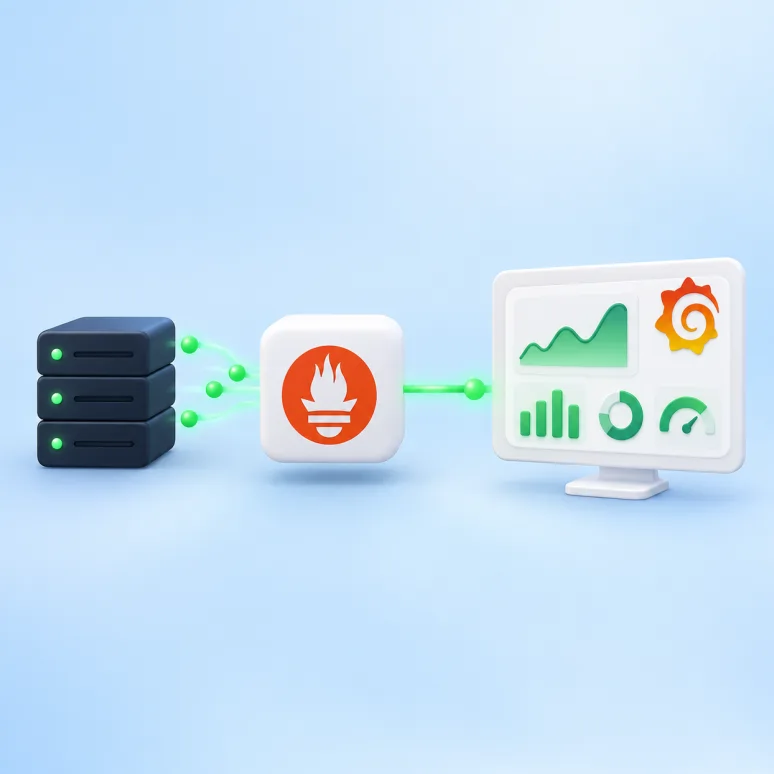
Prometheus دارای رابط ساده ای برای اجرای Query و مشاهده نتایج است، اما امکانات آن برای ساخت داشبوردهای پیشرفته محدودتر از Grafana است. Grafana می تواند Prometheus را به عنوان Data Source دریافت کند و Queryهای PromQL را روی داده های آن اجرا نماید.
فرایند ارتباط Prometheus و Grafana به این صورت است:
۱. Prometheus متریک ها را از سرورها، برنامه ها و Exporterها جمع آوری می کند.
۲. متریک ها در پایگاه داده سری زمانی Prometheus ذخیره می شوند.
۳. Grafana از طریق API به Prometheus متصل می شود.
۴. Queryهای PromQL از داخل پنل های Grafana اجرا می شوند.
۵. نتایج به صورت نمودار، جدول، عدد یا وضعیت رنگی در داشبورد نمایش داده می شوند.
برای مثال، Prometheus می تواند میزان مصرف پردازنده، حافظه آزاد، فضای دیسک، نرخ درخواست ها و تعداد خطاها را جمع آوری کند. Grafana همین اطلاعات را در یک داشبورد نمایش می دهد تا تیم فنی بتواند وضعیت چندین سرور یا سرویس را به صورت همزمان بررسی کند.
وظیفه اصلی Prometheus:
- جمع آوری متریک ها
- ذخیره داده های سری زمانی
- اجرای Queryهای PromQL
- بررسی قوانین هشدار
- ارسال هشدارها به Alertmanager
وظیفه اصلی Grafana:
- اتصال به Prometheus و سایر منابع داده
- ساخت داشبوردهای مانیتورینگ
- نمایش متریک ها در قالب نمودار و جدول
- مقایسه داده ها در بازه های زمانی مختلف
- ساده سازی مشاهده وضعیت زیرساخت
Grafana داده های Prometheus را جایگزین یا دوباره تولید نمی کند، بلکه آنها را از Prometheus دریافت کرده و به شکل بصری نمایش می دهد. از طرف دیگر، Prometheus نیز برای جمع آوری متریک ها به Grafana وابسته نیست و حتی بدون آن می تواند داده ها را ذخیره، تحلیل و برای شرایط غیرعادی هشدار ایجاد کند.
به زبان ساده، Prometheus موتور جمع آوری و تحلیل متریک ها است و Grafana پنل نمایش و ساخت داشبورد برای این داده ها محسوب می شود. ترکیب این دو ابزار، یکی از روش های متداول برای راه اندازی سیستم مانیتورینگ زیرساخت، برنامه ها و محیط های Kubernetes است.
برای آشنایی کامل با قابلیت ها، منابع داده، داشبوردها و نحوه استفاده از این ابزار، مقاله Grafana چیست را مطالعه کنید.
کاربردهای Prometheus چیست؟
Prometheus برای جمع آوری و تحلیل متریک های عددی از سرورها، برنامه ها، APIها، کانتینرها، کلاسترهای Kubernetes و پایگاه های داده استفاده می شود. این ابزار به تیم های فنی کمک می کند وضعیت زیرساخت را به صورت مداوم بررسی کرده و تغییرات غیرعادی را سریع تر شناسایی کنند.
مهم ترین کاربرد Prometheus، تبدیل اطلاعات خام زیرساخت به متریک های قابل جستجو و تحلیل است. این متریک ها می توانند برای ساخت داشبورد، بررسی عملکرد، تحلیل مشکلات و ایجاد هشدار استفاده شوند.
مانیتورینگ سرورها با Prometheus
Prometheus با استفاده از ابزارهایی مانند Node Exporter می تواند متریک های سیستم عامل و منابع سخت افزاری سرورها را جمع آوری کند. این اطلاعات تصویری دقیق از وضعیت فعلی و تغییرات عملکرد سرور در طول زمان ارائه می دهند.
مهم ترین متریک های قابل بررسی عبارتند از:
- میزان مصرف پردازنده
- مقدار حافظه آزاد و استفاده شده
- فضای دیسک
- بار سیستم
- ترافیک شبکه
- تعداد فرایندها
- زمان روشن بودن سرور
بررسی این متریک ها می تواند به شناسایی مشکلاتی مانند افزایش مصرف منابع، پر شدن دیسک یا کاهش ظرفیت سرور کمک کند.
مانیتورینگ برنامه ها و APIها
برنامه ها می توانند با استفاده از Client Library یا Exporter اختصاصی، متریک های عملکردی خود را در اختیار Prometheus قرار دهند. این متریک ها فقط به منابع سرور محدود نیستند و می توانند وضعیت واقعی عملکرد یک نرم افزار را نشان دهند.
برای مانیتورینگ برنامه ها و APIها می توان شاخص های زیر را بررسی کرد:
- تعداد درخواست های دریافتی
- زمان پاسخ API
- نرخ خطا
- تعداد درخواست های در حال پردازش
- تعداد عملیات موفق و ناموفق
- طول صف پردازش
- مدت اجرای فرایندها
برای مثال، افزایش همزمان زمان پاسخ و نرخ خطا می تواند نشانه ایجاد مشکل در برنامه، پایگاه داده یا یکی از سرویس های وابسته باشد.
مانیتورینگ کانتینرها
در زیرساخت های کانتینری، نمونه های مختلف برنامه ممکن است به سرعت ایجاد، حذف یا جابه جا شوند. Prometheus می تواند متریک های مربوط به مصرف منابع و عملکرد کانتینرها را جمع آوری کند و تغییرات آنها را در طول زمان نشان دهد.
در مانیتورینگ کانتینرها معمولا موارد زیر بررسی می شوند:
- مصرف پردازنده هر کانتینر
- میزان استفاده از حافظه
- ترافیک شبکه
- ورودی و خروجی دیسک
- تعداد راه اندازی مجدد
- وضعیت اجرای کانتینر
این اطلاعات به تیم فنی کمک می کنند کانتینرهای پرمصرف، ناپایدار یا دارای محدودیت منابع را شناسایی کند.
مانیتورینگ Kubernetes
Prometheus برای مانیتورینگ محیط های پویا و کلاسترهای Kubernetes کاربرد گسترده ای دارد. قابلیت Service Discovery به Prometheus اجازه می دهد منابع جدید را شناسایی کرده و متریک های مربوط به Nodeها، Podها، Containerها و Serviceها را جمع آوری کند.
با استفاده از Prometheus در Kubernetes می توان مواردی مانند مصرف منابع، وضعیت Podها، تعداد راه اندازی مجدد کانتینرها و عملکرد برنامه های مستقر در کلاستر را بررسی کرد. نحوه استفاده از Prometheus در Kubernetes در بخش بعدی با جزئیات بیشتری توضیح داده می شود.
پایش پایگاه داده
Prometheus با استفاده از Exporterهای مخصوص می تواند متریک های عملکردی پایگاه های داده را جمع آوری کند. نوع متریک ها به پایگاه داده و Exporter مورد استفاده بستگی دارد.
مهم ترین شاخص های قابل بررسی عبارتند از:
- تعداد اتصال های فعال
- مدت اجرای Queryها
- تعداد تراکنش ها
- تعداد خطاها
- وضعیت Replication
- تعداد Queryهای در انتظار
- مصرف حافظه
- وضعیت قفل ها
افزایش غیرعادی اتصال ها، کند شدن Queryها یا ایجاد اختلال در Replication می تواند بر عملکرد برنامه تاثیر بگذارد. مشاهده این تغییرات به تیم فنی کمک می کند منبع مشکل را سریع تر پیدا کند.
ایجاد هشدار پیش از اختلال
یکی از مهم ترین کاربردهای Prometheus، ایجاد هشدار براساس متریک ها و شرایط تعریف شده است. تیم فنی می تواند قوانینی تنظیم کند که با عبور یک متریک از محدوده مشخص یا ادامه یک وضعیت غیرعادی، هشدار فعال شود.
برای مثال، می توان برای شرایط زیر هشدار تعریف کرد:
- مصرف پردازنده بیشتر از ۹۰ درصد
- کاهش فضای آزاد دیسک
- افزایش نرخ خطاهای API
- بالا رفتن زمان پاسخ سرویس
- توقف پاسخ گویی یک سرور
- افزایش تعداد راه اندازی مجدد کانتینرها
- قطع شدن ارتباط با پایگاه داده
این هشدارها می توانند مشکلات احتمالی را پیش از تبدیل شدن به اختلال گسترده آشکار کنند. البته اثربخشی سیستم هشدار به انتخاب متریک مناسب، تعیین آستانه دقیق و جلوگیری از اعلان های غیرضروری بستگی دارد.
در مجموع، Prometheus برای مشاهده وضعیت فعلی، تحلیل روندها و شناسایی رفتار غیرعادی در اجزای مختلف زیرساخت استفاده می شود. ترکیب متریک های فنی، Queryهای PromQL و هشدارهای هدفمند می تواند زمان شناسایی و بررسی مشکلات را کاهش دهد.
استفاده از Prometheus در Kubernetes
Prometheus یکی از ابزارهای پرکاربرد برای مانیتورینگ Kubernetes است. این ابزار می تواند متریک های مربوط به Nodeها، Podها، کانتینرها، Serviceها و برنامه های داخل کلاستر را جمع آوری کند و وضعیت آنها را در طول زمان نشان دهد.
محیط Kubernetes دائما در حال تغییر است و ممکن است Podها به صورت خودکار ایجاد، حذف یا روی Node دیگری اجرا شوند. Prometheus با استفاده از Service Discovery می تواند این تغییرات را شناسایی کرده و Targetهای مانیتورینگ را بدون نیاز به تعریف دستی مداوم به روز کند.
کشف خودکار منابع Kubernetes
Prometheus می تواند از طریق Kubernetes API اطلاعات مربوط به منابع کلاستر را دریافت کند. به این ترتیب، Podها، Serviceها، Endpointها و Nodeهای جدید به صورت خودکار شناسایی می شوند.
با استفاده از Labelها و Annotationهای Kubernetes می توان مشخص کرد کدام منابع باید مانیتور شوند و چه متریک هایی از آنها جمع آوری شود. این قابلیت باعث می شود سیستم مانیتورینگ همزمان با تغییر و توسعه کلاستر به روز باقی بماند.
جمع آوری متریک های Pod، کانتینر و Node
Prometheus می تواند متریک های چند لایه مختلف Kubernetes را جمع آوری کند. نوع و جزئیات متریک ها به ابزارها و تنظیمات مورد استفاده بستگی دارد.
مهم ترین متریک های قابل بررسی عبارتند از:
- مصرف پردازنده و حافظه Nodeها
- مصرف منابع هر Pod و کانتینر
- تعداد راه اندازی مجدد کانتینرها
- وضعیت آماده بودن Podها
- تعداد Podهای در انتظار اجرا
- وضعیت Deploymentها
- ترافیک شبکه
- تعداد Replicaهای موجود و مورد انتظار
Node Exporter معمولا برای جمع آوری متریک های سیستم عامل Nodeها استفاده می شود. متریک های منابع کانتینرها نیز می توانند از طریق اجزای Kubernetes جمع آوری شوند. ابزار kube-state-metrics نیز اطلاعات مربوط به وضعیت آبجکت هایی مانند Pod، Deployment و StatefulSet را به متریک های قابل استفاده در Prometheus تبدیل می کند.
نظارت بر سلامت و عملکرد کلاستر
Prometheus به تیم فنی کمک می کند سلامت کلی کلاستر و عملکرد برنامه های مستقر در آن را بررسی کند. برای مثال، افزایش تعداد Podهای ناموفق، کاهش ظرفیت یک Node یا تکرار راه اندازی مجدد کانتینرها می تواند نشانه وجود مشکل باشد.
با تعریف Query و قوانین هشدار می توان شرایطی مانند موارد زیر را شناسایی کرد:
- خارج شدن یک Node از وضعیت آماده
- افزایش مصرف حافظه یک Pod
- متوقف شدن یک Deployment
- تفاوت میان Replicaهای مورد انتظار و موجود
- افزایش نرخ خطاهای برنامه
- کاهش فضای آزاد دیسک Node
- راه اندازی مجدد مکرر کانتینرها
هشدارهای ایجاد شده توسط Prometheus برای Alertmanager ارسال می شوند تا براساس شدت، سرویس یا محیط به تیم مسئول اطلاع داده شوند.
چرا Prometheus برای Kubernetes محبوب است؟
Prometheus به دلیل مدل داده چندبعدی، پشتیبانی از Labelها، زبان PromQL و قابلیت Service Discovery با ساختار پویای Kubernetes سازگاری مناسبی دارد. Labelها امکان تفکیک و تحلیل متریک ها براساس کلاستر، Namespace، Pod، Container یا Service را فراهم می کنند.
همچنین اکوسیستم گسترده Prometheus و امکان اتصال آن به Grafana و Alertmanager، ساخت داشبورد و سیستم هشداردهی را ساده تر می کند. به همین دلیل، Prometheus در بسیاری از زیرساخت های مبتنی بر Kubernetes به عنوان یکی از اجزای اصلی مانیتورینگ استفاده می شود.
برای آشنایی با ساختار Node، Pod، Service و سایر اجزای این پلتفرم، نحوه کار و اجزای کلاستر را در مقاله Kubernetes چیست بررسی کرده ایم.
در مجموع، Prometheus با کشف خودکار منابع و جمع آوری متریک های چند لایه، امکان مشاهده وضعیت کلاستر Kubernetes را فراهم می کند. البته کیفیت مانیتورینگ به انتخاب متریک های مناسب، تنظیم دقیق Targetها و طراحی هشدارهای کاربردی وابسته است.
مزایای Prometheus چیست؟
Prometheus یک ابزار متن باز، انعطاف پذیر و قابل اعتماد برای جمع آوری و تحلیل متریک های زیرساخت و برنامه ها است. سازگاری مناسب با محیط های پویا، زبان جستجوی قدرتمند و امکان اتصال به ابزارهای مختلف از مهم ترین دلایل استفاده گسترده از Prometheus در سیستم های مانیتورینگ هستند.
مهم ترین مزایای Prometheus عبارتند از:
۱. متن باز و رایگان بودن
Prometheus یک پروژه متن باز است و برای استفاده از قابلیت های اصلی آن نیازی به خرید مجوز نرم افزاری وجود ندارد. کد منبع، مستندات و ابزارهای مرتبط با آن در دسترس هستند و جامعه کاربری فعالی در توسعه و بهبود این پروژه مشارکت دارد.
البته رایگان بودن نرم افزار به معنای بدون هزینه بودن سیستم مانیتورینگ نیست؛ زیرا راه اندازی، نگهداری، ذخیره سازی و مدیریت آن همچنان به منابع زیرساختی و نیروی متخصص نیاز دارد.
۲. مدل داده چندبعدی
Prometheus متریک ها را همراه با Labelها ذخیره می کند. Labelها امکان تفکیک و تحلیل داده ها براساس ویژگی هایی مانند نام سرویس، سرور، محیط، کلاستر یا وضعیت پاسخ را فراهم می سازند.
این مدل چندبعدی باعث می شود بتوان یک متریک را از زوایای مختلف بررسی کرد، بدون آنکه برای هر حالت نام متریک جداگانه ای ایجاد شود.
۳. زبان جستجوی قدرتمند PromQL
PromQL امکان فیلتر، گروه بندی، محاسبه و تجمیع متریک های سری زمانی را فراهم می کند. با استفاده از این زبان می توان نرخ درخواست ها، درصد خطاها، میانگین مصرف منابع و بسیاری از شاخص های عملکردی را محاسبه کرد.
نتایج Queryهای PromQL می توانند برای تحلیل مستقیم، ساخت داشبورد یا تعریف قوانین هشدار استفاده شوند.
۴. سازگاری مناسب با Kubernetes
قابلیت Service Discovery و استفاده گسترده از Labelها، Prometheus را به گزینه مناسبی برای مانیتورینگ Kubernetes تبدیل کرده است. این ابزار می تواند منابع جدید را شناسایی کند و متریک های مربوط به Nodeها، Podها، کانتینرها و Serviceها را جمع آوری نماید.
این ویژگی در محیط هایی که منابع آنها دائما ایجاد، حذف یا جابه جا می شوند، اهمیت زیادی دارد.
۵. جمع آوری خودکار متریک ها
Prometheus به طور پیش فرض از مدل Pull استفاده می کند و در بازه های زمانی مشخص متریک ها را از Targetها دریافت می کند. تنظیمات جمع آوری داده، فاصله زمانی Scrape و وضعیت Targetها به صورت متمرکز قابل مدیریت هستند.
اگر یک Target در دسترس نباشد، Prometheus می تواند شکست فرایند جمع آوری را ثبت کند و برای آن هشدار ایجاد نماید.
۶. سیستم هشداردهی انعطاف پذیر
در Prometheus می توان قوانین هشدار را براساس Queryهای PromQL تعریف کرد. به این ترتیب، هشدارها فقط به عبور یک مقدار از آستانه ثابت محدود نیستند و می توانند براساس نرخ تغییر، میانگین زمانی یا ترکیب چند شرط ایجاد شوند.
هشدارهای فعال برای Alertmanager ارسال می شوند تا گروه بندی، مسیریابی و از طریق کانال مناسب به تیم مسئول اطلاع داده شوند.
۷. امکان اتصال به ابزارهای مختلف
Prometheus دارای Exporterها و Integrationهای متنوعی برای سرورها، پایگاه های داده، تجهیزات شبکه، سرویس های ابری و برنامه ها است. همچنین می توان با استفاده از Client Libraryها، متریک های اختصاصی را مستقیما در برنامه تعریف کرد.
اتصال Prometheus به Grafana نیز امکان ساخت داشبوردهای حرفه ای و نمایش بصری متریک ها را فراهم می کند.
۸. استقلال و سادگی معماری اصلی
هر سرور Prometheus می تواند متریک ها را به صورت مستقل جمع آوری و ذخیره کند و برای فعالیت اصلی خود به ذخیره سازی توزیع شده وابسته نیست. این معماری باعث می شود حتی هنگام بروز اختلال در بخش هایی از زیرساخت، داده های مانیتورینگ محلی همچنان در دسترس باشند.
۹. مناسب برای تحلیل لحظه ای و روندها
Prometheus علاوه بر نمایش وضعیت فعلی، امکان تحلیل تغییر متریک ها در بازه های زمانی مختلف را فراهم می کند. تیم فنی می تواند با بررسی روندها، افزایش تدریجی مصرف منابع یا کاهش عملکرد یک سرویس را شناسایی کند.
۱۰. جامعه کاربری و اکوسیستم گسترده
Prometheus در پروژه های ابری و زیرساخت های مبتنی بر کانتینر کاربرد گسترده ای دارد. وجود مستندات رسمی، Exporterهای متعدد و ابزارهای مکمل، پیاده سازی آن را برای فناوری های مختلف ساده تر می کند.
در مجموع، مهم ترین مزیت Prometheus ترکیب مدل داده سری زمانی، PromQL، Service Discovery و هشداردهی انعطاف پذیر است. این قابلیت ها Prometheus را به گزینه ای مناسب برای مانیتورینگ سرورها، برنامه ها، APIها و کلاسترهای Kubernetes تبدیل می کنند. با این حال، برای انتخاب درست باید محدودیت های آن نیز در کنار این مزایا بررسی شوند.
محدودیت های Prometheus چیست؟
Prometheus با وجود قابلیت های گسترده، برای تمام نیازهای مانیتورینگ و ذخیره سازی داده مناسب نیست. محدودیت های اصلی آن به ذخیره سازی بلندمدت، مقیاس پذیری، تعداد زیاد سری های زمانی، مدیریت دسترسی و استفاده از داده هایی غیر از متریک مربوط می شوند.
مهم ترین محدودیت های Prometheus عبارتند از:
۱. مناسب نبودن برای ثبت اطلاعات مالی دقیق
Prometheus برای مانیتورینگ طراحی شده است و تضمین نمی کند که تمام داده ها بدون هیچ وقفه یا کمبودی جمع آوری شوند. اگر یک Target موقتا در دسترس نباشد، بخشی از متریک ها ممکن است ثبت نشوند.
به همین دلیل، Prometheus برای محاسبه صورتحساب، ثبت تراکنش های مالی یا اطلاعاتی که باید با دقت صددرصد نگهداری شوند، انتخاب مناسبی نیست. این داده ها باید در یک سیستم تراکنشی یا پایگاه داده تخصصی ذخیره شوند.
۲. محدودیت ذخیره سازی بلندمدت
Prometheus داده ها را به صورت محلی در پایگاه داده سری زمانی خود ذخیره می کند. این روش برای مانیتورینگ روزمره و نگهداری داده ها در بازه های محدود مناسب است، اما با افزایش مدت نگهداری و حجم متریک ها، فضای ذخیره سازی بیشتری مصرف می شود.
برای نگهداری بلندمدت، ذخیره حجم زیاد داده یا ایجاد یک نمای یکپارچه از چند سرور Prometheus معمولا باید از راهکارهای Remote Storage یا ابزارهای مکمل استفاده شود.
۳. افزایش تعداد سری های زمانی
هر ترکیب متفاوت از نام متریک و Labelها یک سری زمانی جدید ایجاد می کند. اگر Labelهایی با مقادیر بسیار متنوع مانند شناسه کاربر، شماره سفارش، آدرس کامل درخواست یا شناسه تراکنش استفاده شوند، تعداد سری های زمانی می تواند به شدت افزایش پیدا کند.
این وضعیت که High Cardinality نامیده می شود، مصرف حافظه، فضای ذخیره سازی و زمان اجرای Queryها را افزایش می دهد. بنابراین انتخاب Labelها باید با دقت و براساس نیاز واقعی مانیتورینگ انجام شود.
۴. پیچیدگی در زیرساخت های بسیار بزرگ
یک سرور Prometheus می تواند حجم قابل توجهی از متریک ها را پردازش کند، اما در زیرساخت های بسیار بزرگ ممکن است یک نمونه برای تمام داده ها کافی نباشد. در چنین شرایطی، تقسیم Targetها میان چند سرور، استفاده از Federation یا اتصال به سیستم ذخیره سازی مقیاس پذیر ضروری می شود.
این معماری مدیریت تنظیمات، نگهداری داده ها و اجرای Queryهای سراسری را پیچیده تر می کند و به طراحی دقیق تری نیاز دارد.
۵. نبود High Availability کامل به صورت پیش فرض
هر سرور Prometheus به صورت مستقل فعالیت می کند. برای جلوگیری از توقف مانیتورینگ در صورت خرابی سرور اصلی، معمولا دو نمونه مشابه Prometheus اجرا می شوند تا متریک های یکسان را جمع آوری کنند.
راه اندازی High Availability، حذف داده های تکراری و ایجاد نمای یکپارچه از چند نمونه به تنظیمات یا ابزارهای مکمل نیاز دارد و به صورت خودکار با نصب یک سرور Prometheus فراهم نمی شود.
۶. تمرکز اصلی بر متریک ها
Prometheus برای جمع آوری و تحلیل متریک های عددی طراحی شده است و ابزار اصلی ذخیره و جستجوی لاگ یا Trace محسوب نمی شود. متریک ها نشان می دهند چه تغییری در سیستم رخ داده است، اما همیشه جزئیات کامل علت آن را مشخص نمی کنند.
برای تحلیل جامع تر مشکلات، Prometheus معمولا در کنار سیستم های مدیریت لاگ و ابزارهای Distributed Tracing استفاده می شود.
۷. نیاز به تنظیم دقیق هشدارها
Prometheus امکان تعریف هشدارهای انعطاف پذیر را فراهم می کند، اما انتخاب نادرست آستانه ها می تواند باعث ایجاد تعداد زیادی هشدار غیرضروری یا از دست رفتن مشکلات مهم شود.
برای طراحی هشدارهای موثر باید رفتار عادی سیستم، شدت مشکل، مدت ادامه وضعیت و تاثیر آن بر کاربران در نظر گرفته شود. تنظیم هشدار صرفا براساس یک مقدار ثابت همیشه نتیجه مناسبی ندارد.
۸. امکانات محدود رابط کاربری داخلی
رابط وب Prometheus برای اجرای Query، مشاهده Targetها و بررسی اولیه متریک ها مناسب است، اما امکانات محدودی برای ساخت داشبوردهای مدیریتی و گزارش های تصویری دارد.
به همین دلیل، Prometheus معمولا به Grafana متصل می شود تا داده ها در قالب نمودار، جدول و داشبوردهای قابل تنظیم نمایش داده شوند.
در مجموع، Prometheus برای مانیتورینگ متریک ها و شناسایی وضعیت غیرعادی بسیار مناسب است، اما جایگزین پایگاه داده تراکنشی، سیستم مدیریت لاگ یا راهکار ذخیره سازی بلندمدت نیست. پیش از پیاده سازی آن باید حجم متریک ها، مدت نگهداری داده، نیاز به دسترس پذیری بالا و مقیاس زیرساخت بررسی شود.
Prometheus برای چه پروژه هایی مناسب است؟
Prometheus برای پروژه هایی مناسب است که به جمع آوری منظم متریک ها، مشاهده وضعیت زیرساخت، تحلیل عملکرد و ایجاد هشدار نیاز دارند. این ابزار به ویژه در زیرساخت های پویا، معماری میکروسرویس و محیط های Kubernetes عملکرد مناسبی دارد.
با این حال، انتخاب Prometheus فقط به اندازه پروژه بستگی ندارد. تعداد سرورها، حجم متریک ها، مدت نگهداری داده، نوع اطلاعات و نیاز به دسترس پذیری بالا نیز باید بررسی شوند.
| نوع پروژه | میزان تناسب | دلیل |
|---|---|---|
| یک سرور یا پروژه کوچک | مناسب با توجه به نیاز | اگر پروژه به متریک، داشبورد و هشدار نیاز داشته باشد، Prometheus قابل استفاده است؛ اما ممکن است برای پروژه بسیار ساده بیش از حد نیاز باشد. |
| زیرساخت چند سروری | مناسب | امکان جمع آوری متمرکز متریک ها و مقایسه وضعیت چند سرور را فراهم می کند. |
| برنامه های مبتنی بر میکروسرویس | بسیار مناسب | مدل داده چندبعدی و Labelها برای تفکیک و تحلیل سرویس های متعدد کاربرد دارند. |
| کلاستر Kubernetes | بسیار مناسب | Service Discovery و Labelها با ساختار پویا و متغیر Kubernetes سازگاری مناسبی دارند. |
| مانیتورینگ برنامه و API | مناسب | برای بررسی نرخ درخواست، زمان پاسخ، تعداد خطا و شاخص های اختصاصی برنامه قابل استفاده است. |
| ذخیره سازی بسیار بلندمدت | نیازمند ابزار مکمل | برای نگهداری حجم زیاد داده در بلندمدت معمولا به Remote Storage یا راهکار مکمل نیاز دارد. |
| مدیریت و تحلیل لاگ | نامناسب به تنهایی | Prometheus برای متریک های عددی طراحی شده است و سیستم اصلی مدیریت لاگ محسوب نمی شود. |
| صورتحساب و ثبت تراکنش مالی | نامناسب | Prometheus تضمین کننده ثبت کامل و دقیق تمام رویدادهای مالی و تراکنشی نیست. |
چه زمانی Prometheus انتخاب مناسبی است؟
استفاده از Prometheus در شرایط زیر می تواند انتخاب مناسبی باشد:
- زیرساخت شامل چند سرور، سرویس یا برنامه است.
- متریک های سیستم باید در بازه های زمانی مشخص جمع آوری شوند.
- تیم فنی به تحلیل روند مصرف منابع نیاز دارد.
- برنامه براساس معماری میکروسرویس اجرا می شود.
- زیرساخت از کانتینر یا Kubernetes استفاده می کند.
- برای خطاها و تغییرات غیرعادی باید هشدار ایجاد شود.
- متریک های اختصاصی برنامه یا کسب و کار باید بررسی شوند.
- داده ها باید در Grafana به صورت داشبورد نمایش داده شوند.
چه زمانی Prometheus به تنهایی کافی نیست؟
Prometheus در شرایط زیر باید همراه با ابزارهای دیگر استفاده شود یا با راهکار مناسب تری جایگزین گردد:
- اطلاعات باید با دقت صددرصد برای صورتحساب یا تراکنش مالی ثبت شوند.
- هدف اصلی، جمع آوری و جستجوی لاگ ها است.
- داده ها باید برای مدت بسیار طولانی و در حجم زیاد نگهداری شوند.
- تحلیل جزئی مسیر هر درخواست در چند سرویس مورد نیاز است.
- پروژه به گزارش های مدیریتی پیچیده و غیرعملیاتی نیاز دارد.
- زیرساخت بسیار بزرگ است و یک سرور Prometheus پاسخ گوی حجم متریک ها نیست.
در مجموع، Prometheus برای مانیتورینگ عملیاتی سرورها، برنامه ها، APIها، کانتینرها و Kubernetes مناسب است. اگر نیاز پروژه شامل ذخیره سازی بلندمدت، مدیریت لاگ، ردیابی درخواست ها یا ثبت دقیق تراکنش ها باشد، باید ابزارهای مکمل نیز در معماری مانیتورینگ در نظر گرفته شوند.
تفاوت Prometheus با ابزارهای مانیتورینگ دیگر
Prometheus، Grafana، Zabbix و Nagios همگی در حوزه مانیتورینگ استفاده می شوند، اما نقش و معماری یکسانی ندارند. Prometheus بیشتر بر جمع آوری و تحلیل متریک های سری زمانی تمرکز دارد، Grafana ابزار نمایش و تحلیل داده است و Zabbix و Nagios راهکارهای مانیتورینگ با ساختار و روش متفاوت محسوب می شوند.
انتخاب میان این ابزارها باید براساس نوع زیرساخت، پویایی منابع، نیاز به داشبورد، روش هشداردهی و میزان تخصص تیم فنی انجام شود.
| ابزار | کاربرد اصلی | روش کار | مناسب برای |
|---|---|---|---|
| Prometheus | جمع آوری، ذخیره و تحلیل متریک ها | دریافت دوره ای متریک ها و تحلیل آنها با PromQL | زیرساخت ابری، میکروسرویس و Kubernetes |
| Grafana | نمایش و تحلیل بصری داده ها | اتصال به منابع داده و ساخت داشبورد | نمودار، داشبورد و مشاهده یکپارچه داده ها |
| Zabbix | مانیتورینگ یکپارچه زیرساخت | جمع آوری داده با Agent، پروتکل های شبکه و روش های بدون Agent | سرورها، شبکه ها و زیرساخت های سازمانی |
| Nagios | بررسی وضعیت Host و Service | اجرای Checkها و Pluginها و بررسی نتیجه آنها | سیستم های کوچک، ثابت و بررسی دسترس پذیری |
تفاوت Prometheus و Grafana چیست؟
Prometheus و Grafana جایگزین یکدیگر نیستند. Prometheus متریک ها را از Targetها جمع آوری می کند، آنها را در پایگاه داده سری زمانی ذخیره می سازد و امکان تحلیل با PromQL را فراهم می کند. Grafana به منابع داده مختلف از جمله Prometheus متصل می شود و اطلاعات را در قالب نمودار و داشبورد نمایش می دهد.
Prometheus دارای رابط ساده ای برای اجرای Query و مشاهده داده ها است، اما Grafana امکانات گسترده تری برای طراحی داشبورد، ترکیب منابع داده و نمایش بصری اطلاعات دارد. به همین دلیل، این دو ابزار معمولا در کنار یکدیگر استفاده می شوند.
به زبان ساده، Prometheus مسئول جمع آوری و ذخیره متریک ها است و Grafana آنها را به شکل قابل فهم نمایش می دهد. Grafana علاوه بر متریک، امکان جستجو و نمایش داده هایی مانند لاگ و Trace را نیز از منابع سازگار فراهم می کند.
تفاوت Prometheus و Zabbix چیست؟
Zabbix یک راهکار مانیتورینگ یکپارچه برای بررسی سرورها، تجهیزات شبکه، ماشین های مجازی، سرویس ها و سایر اجزای زیرساخت است. این ابزار قابلیت هایی مانند جمع آوری داده، داشبورد، هشداردهی و مدیریت Hostها را در یک سیستم ارائه می دهد.
Prometheus بیشتر بر متریک های سری زمانی، مدل داده مبتنی بر Label و تحلیل با PromQL تمرکز دارد. Service Discovery نیز استفاده از آن را در زیرساخت های پویا و محیط های Kubernetes ساده تر می کند.
به طور کلی:
- Prometheus برای محیط های ابری، میکروسرویس و Kubernetes انتخاب رایجی است.
- Zabbix برای مانیتورینگ متمرکز سرورها، شبکه ها و زیرساخت های سازمانی مناسب است.
- Prometheus انعطاف بیشتری برای تحلیل متریک های چندبعدی دارد.
- Zabbix بسیاری از قابلیت های مانیتورینگ را در یک رابط یکپارچه ارائه می دهد.
انتخاب میان Prometheus و Zabbix به نوع زیرساخت بستگی دارد و هیچ کدام در تمام پروژه ها برتر نیستند.
تفاوت Prometheus و Nagios چیست؟
Nagios بیشتر بر بررسی وضعیت Hostها و Serviceها با استفاده از Checkها و Pluginها تمرکز دارد. نتیجه هر بررسی معمولا مشخص می کند یک سرویس در وضعیت سالم، هشدار یا بحرانی قرار دارد.
Prometheus علاوه بر بررسی وضعیت فعلی، متریک های سری زمانی را ذخیره می کند و امکان تحلیل تغییرات آنها را در طول زمان فراهم می سازد. استفاده از Labelها و PromQL نیز فیلتر، گروه بندی و تحلیل متریک ها را ساده تر می کند.
Nagios می تواند برای سیستم های کوچک یا ثابت و بررسی دسترس پذیری سرویس ها مناسب باشد. Prometheus معمولا برای مانیتورینگ Whitebox، زیرساخت های پویا، برنامه های ابری و Kubernetes انتخاب مناسب تری است. مستندات رسمی Prometheus نیز Nagios را بیشتر مناسب بررسی های پایه در سیستم های کوچک یا ثابت معرفی می کند.
در مجموع، Prometheus برای جمع آوری و تحلیل متریک ها، Grafana برای نمایش داده ها، Zabbix برای مانیتورینگ یکپارچه زیرساخت و Nagios برای Checkهای وضعیت محور استفاده می شود. انتخاب ابزار مناسب باید براساس معماری پروژه و نیازهای واقعی مانیتورینگ انجام شود.
سوالات متداول درباره Prometheus
Prometheus چیست و چه کاربردی دارد؟
Prometheus یک ابزار متن باز برای جمع آوری، ذخیره و تحلیل متریک های سری زمانی است. این ابزار برای مانیتورینگ سرورها، برنامه ها، APIها، کانتینرها و کلاسترهای Kubernetes استفاده می شود و می تواند براساس شرایط تعریف شده هشدار ایجاد کند.
آیا Prometheus رایگان است؟
بله، Prometheus یک نرم افزار متن باز و رایگان است و قابلیت های اصلی آن به خرید مجوز نیاز ندارند. با این حال، راه اندازی، نگهداری، فضای ذخیره سازی و مدیریت سیستم مانیتورینگ می تواند هزینه زیرساخت و نیروی متخصص داشته باشد.
تفاوت Prometheus و Grafana چیست؟
Prometheus متریک ها را جمع آوری و ذخیره می کند و امکان تحلیل آنها با PromQL را فراهم می سازد. Grafana به Prometheus و سایر منابع داده متصل می شود و اطلاعات را در قالب نمودار، جدول و داشبورد نمایش می دهد. این دو ابزار مکمل یکدیگر هستند.
آیا Prometheus برای مانیتورینگ Kubernetes مناسب است؟
بله، Prometheus به دلیل پشتیبانی از Service Discovery، مدل داده مبتنی بر Label و سازگاری با محیط های پویا، یکی از ابزارهای پرکاربرد برای مانیتورینگ Kubernetes است. این ابزار می تواند متریک های Nodeها، Podها، کانتینرها و برنامه های داخل کلاستر را جمع آوری کند.
PromQL چیست؟
PromQL زبان جستجو و تحلیل داده های Prometheus است. با استفاده از PromQL می توان متریک ها را فیلتر، گروه بندی و تجمیع کرد، نرخ تغییر آنها را محاسبه نمود و برای داشبوردها یا قوانین هشدار Query ساخت.
آیا Prometheus اطلاعات لاگ را ذخیره می کند؟
Prometheus برای ذخیره و تحلیل متریک های عددی طراحی شده است و سیستم اصلی مدیریت لاگ محسوب نمی شود. برای بررسی کامل مشکلات، معمولا Prometheus در کنار یک ابزار جمع آوری و جستجوی لاگ استفاده می شود.
آیا Prometheus بدون Grafana کار می کند؟
بله، Prometheus برای جمع آوری، ذخیره و تحلیل متریک ها به Grafana وابسته نیست و رابط داخلی ساده ای برای اجرای Query دارد. Grafana زمانی استفاده می شود که به داشبوردها و نمایش بصری حرفه ای تری نیاز باشد.
Prometheus برای چه پروژه هایی مناسب نیست؟
Prometheus برای ثبت تراکنش های مالی، محاسبه صورتحساب دقیق، مدیریت اصلی لاگ ها و ذخیره سازی بسیار طولانی مدت به تنهایی مناسب نیست. این ابزار برای چنین نیازهایی باید همراه با سیستم های تخصصی یا ابزارهای مکمل استفاده شود.
جمع بندی؛ آیا Prometheus انتخاب مناسبی است؟
Prometheus یک ابزار متن باز برای جمع آوری، ذخیره و تحلیل متریک های سری زمانی است. این ابزار با استفاده از مدل Pull، متریک ها را از سرورها، برنامه ها و Exporterها دریافت می کند و امکان تحلیل آنها را با زبان PromQL فراهم می سازد.
مدل داده مبتنی بر Label، سیستم هشداردهی انعطاف پذیر و قابلیت Service Discovery باعث شده اند Prometheus برای مانیتورینگ زیرساخت های ابری، برنامه های مبتنی بر میکروسرویس و کلاسترهای Kubernetes گزینه مناسبی باشد. اتصال آن به Grafana و Alertmanager نیز امکان ساخت داشبوردهای حرفه ای و مدیریت بهتر هشدارها را فراهم می کند.
با این حال، Prometheus جایگزین سیستم مدیریت لاگ، پایگاه داده تراکنشی یا راهکار تخصصی ذخیره سازی بلندمدت نیست. انتخاب این ابزار باید براساس تعداد منابع، حجم متریک ها، مدت نگهداری داده و نیازهای واقعی مانیتورینگ انجام شود.
در مجموع، اگر هدف پروژه مشاهده وضعیت زیرساخت، تحلیل عملکرد و شناسایی سریع مشکلات با استفاده از متریک ها باشد، Prometheus انتخاب مناسبی است. طراحی درست متریک ها، کنترل Labelها و تنظیم هشدارهای کاربردی نقش مهمی در موفقیت پیاده سازی آن دارند.
پیاده سازی مانیتورینگ زیرساخت با Prometheus
راه اندازی Prometheus فقط به نصب نرم افزار محدود نمی شود. انتخاب متریک های مناسب، تنظیم Exporterها، طراحی Queryهای PromQL، ساخت داشبورد و تعریف هشدارهای کاربردی باید براساس ساختار و نیازهای هر زیرساخت انجام شود.
سربروس در زمینه طراحی و پیاده سازی سیستم های مانیتورینگ برای سرورها، برنامه ها، کانتینرها و کلاسترهای Kubernetes فعالیت می کند. برای بررسی وضعیت زیرساخت و انتخاب راهکار مناسب، می توانید جزئیات خدمات مانیتورینگ سرور را مشاهده کرده و با تیم سربروس در ارتباط باشید.