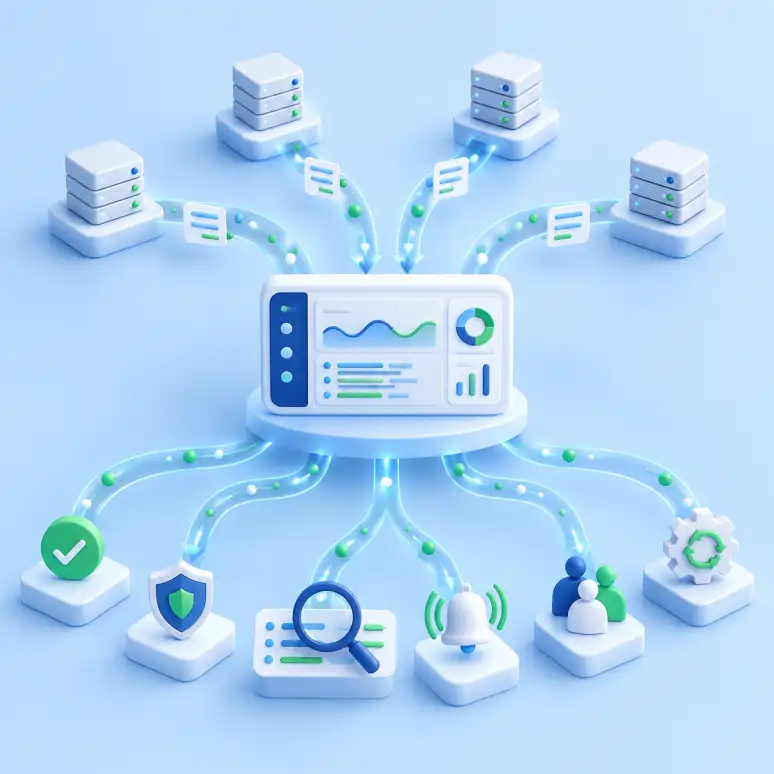
لاگ مانیتورینگ چیست؟ لاگ مانیتورینگ فرایند جمع آوری، متمرکز سازی، جستجو و تحلیل رویدادهای برنامه ها، سرورها و تجهیزات است. این فرایند با ایجاد هشدارهای قابل اقدام کمک می کند خطاها، تهدیدهای امنیتی و افت عملکرد سریع تر شناسایی و ریشه یابی شوند.
در ادامه، معماری لاگ مانیتورینگ، کاربردها، ابزارها، چالش ها و مراحل راه اندازی آن را بررسی می کنیم.
خلاصه سریع
لاگ مانیتورینگ فرایند پیوسته جمع آوری، متمرکز سازی، جستجو و تحلیل رویدادهای ثبت شده در برنامه ها، سرورها و تجهیزات است. این فرایند با هشدارهای قابل اقدام کمک می کند خطا، تهدید امنیتی و افت عملکرد سریع تر شناسایی و ریشه یابی شود.
مهم ترین نکات عبارتند از:
- لاگ جزئیات یک رویداد را ثبت می کند.
- متریک روند عددی وضعیت سیستم را نشان می دهد.
- تریس مسیر یک درخواست میان سرویس ها را مشخص می کند.
- استفاده همزمان از Log، Metric و Trace دید کامل تری از زیرساخت می سازد.
- لاگ های ساخت یافته و دارای شناسه همبستگی، عیب یابی را سریع تر می کنند.
- نگهداری بدون برنامه لاگ ها می تواند هزینه و ریسک امنیتی ایجاد کند.
- ابزار مناسب باید براساس حجم داده، زیرساخت، بودجه و مهارت تیم انتخاب شود.
- لاگ و لاگ مانیتورینگ چیست؟
- لاگ مانیتورینگ چگونه کار می کند؟
- تفاوت Log، Metric و Trace
- کاربردهای لاگ مانیتورینگ
- مزایای لاگ مانیتورینگ
- چالش های لاگ مانیتورینگ
- ابزارهای لاگ مانیتورینگ و معیار انتخاب
- معیارهای انتخاب ابزار
- بهترین روش های پیاده سازی
- لاگ ساخت یافته و استاندارد
- ارتباط لاگ مانیتورینگ با مانیتورینگ سرور
- مراحل راه اندازی لاگ مانیتورینگ
- جمع بندی
- سوالات متداول درباره لاگ مانیتورینگ
لاگ و لاگ مانیتورینگ چیست؟
لاگ رکوردی زمان دار از رویدادی مانند ورود کاربر، پاسخ API، تغییر تنظیمات یا خطای پایگاه داده است. لاگ مانیتورینگ رکوردهای پراکنده را به داده قابل جستجو تبدیل می کند تا تیم بتواند رفتار عادی و غیرعادی را بررسی کند.
اجزای اصلی یک لاگ
یک لاگ استاندارد معمولا شامل زمان ثبت، سطح شدت، نام سرویس، محیط اجرا، شناسه درخواست، نوع رویداد، پیام و اطلاعات زمینه ای است.
برای مثال، یک رویداد خطای پرداخت می تواند مشخص کند خطا در چه زمانی، در کدام سرویس، برای کدام درخواست و با چه کد پاسخی رخ داده است. وجود این اطلاعات به تیم کمک می کند رخدادهای مرتبط را بدون حدس کنار هم قرار دهد.
فیلدهای متداول یک لاگ عبارتند از:
timestamp: زمان دقیق رویدادlevel: سطح شدت مانند INFO یا ERRORservice: نام برنامه یا سرویسenvironment: محیط توسعه، آزمایش یا تولیدrequest_id: شناسه درخواستevent: نوع رویدادmessage: توضیح قابل فهم برای انسانstatus_code: کد نتیجه عملیاتduration_ms: مدت اجرای عملیات
لاگ مانیتورینگ چه مسئله ای را حل می کند؟
در زیرساخت های کوچک ممکن است بررسی مستقیم فایل لاگ یک سرور امکان پذیر باشد. اما با افزایش تعداد سرورها، کانتینرها و سرویس ها، بررسی دستی بسیار کند و خطاپذیر می شود.
ممکن است یک درخواست از چند سرویس عبور کند و خطای نهایی نتیجه اختلال در پایگاه داده یا یک سرویس خارجی باشد. لاگ مانیتورینگ اطلاعات این اجزا را در محیطی مرکزی قرار می دهد تا تیم بتواند مسیر رخداد را بازسازی کند.
این قابلیت زمان تشخیص و رفع اختلال را کاهش می دهد و شواهد لازم برای تحلیل امنیتی، ممیزی و بررسی اثر انتشارهای جدید را فراهم می کند.
لاگ مانیتورینگ چگونه کار می کند؟
این بخش معماری فنی حرکت رویداد از مبدا تا پردازش، ذخیره، جستجو و هشدار را توضیح می دهد. مسیر اجرایی استقرار پروژه با هدف و تحویل مشخص، جداگانه در بخش مراحل راه اندازی آمده است.
تولید و جمع آوری لاگ
در این بخش، منابع عامل جمع کننده بافر و تحمل قطع محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
انتقال و پردازش
در این بخش، صف فیلتر تجزیه غنی سازی و ماسک محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
ذخیره سازی و ایندکس
در این بخش، سرعت جستجو هزینه و چرخه عمر محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
جستجو، همبستگی و تحلیل
در این بخش، فیلد مشترک و بازسازی درخواست محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
داشبورد و هشدار
در این بخش، اثر کاربر و هشدار قابل اقدام محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
تفاوت Log، Metric و Trace
Metric روند عددی را نشان می دهد، Trace مسیر درخواست را دنبال می کند و Log جزئیات رخداد را ارائه می دهد. این سه سیگنال مکمل یکدیگر هستند و کنار هم دید مشاهده پذیری کامل تری می سازند.
| سیگنال | پرسش اصلی | نمونه | کاربرد |
|---|---|---|---|
| Log | چه اتفاقی افتاد؟ | خطای اتصال پایگاه داده | ریشه یابی، امنیت و ممیزی |
| Metric | وضعیت و روند چگونه است؟ | نرخ خطا یا مصرف CPU | داشبورد و هشدار سریع |
| Trace | درخواست کجا زمان مصرف کرد؟ | مسیر درخواست میان سرویس ها | تحلیل تاخیر سیستم توزیع شده |
لاگ چه اطلاعاتی می دهد؟
در این بخش، جزئیات رخداد و زمینه خطا محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
متریک چه اطلاعاتی می دهد؟
در این بخش، روند عددی و هشدار سریع محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
تریس چه اطلاعاتی می دهد؟
در این بخش، مسیر درخواست میان سرویس ها محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
چه زمانی هر سه را کنار هم استفاده کنیم؟
در این بخش، حرکت از نشانه به علت محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
کاربردهای لاگ مانیتورینگ
کاربرد لاگ مانیتورینگ به یافتن خطای برنامه محدود نیست. عملیات زیرساخت، امنیت، ممیزی، پایگاه های داده، شبکه و محیط های کانتینری برای تشخیص و تصمیم به رویدادهای ثبت شده متکی هستند.
عیب یابی برنامه و API
در این بخش، شناسه درخواست نسخه و کد پاسخ محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
امنیت و تشخیص تهدید
در این بخش، ورود ناموفق دسترسی و تغییر حساس محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
ممیزی و انطباق
در این بخش، عامل زمان و سابقه تغییر محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
پایش پایگاه های داده و شبکه
در این بخش، کوئری کند اتصال و افت بسته محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود.
لاگ مانیتورینگ در Kubernetes
در این بخش، برچسب namespace pod و container محور اصلی است. تعریف روشن فیلدها و مسئولیت ها کمک می کند رخدادهای مرتبط بدون حدس کنار هم قرار گیرند و نتیجه بررسی به اقدام مشخص منتهی شود. کنترل دسترسی، حذف داده حساس و ثبت تغییرات باید از ابتدا در نظر گرفته شود. بازبینی پس از حادثه نیز نشان می دهد کدام فیلد کم بوده و کدام هشدار فقط نویز ساخته است.
برای مطالعه بیشتر، راهنمای کوبرنتیز چیست را ببینید.
مزایای لاگ مانیتورینگ
لاگ مانیتورینگ فاصله میان وقوع، تشخیص و رفع مشکل را کاهش می دهد. مهم ترین مزایای آن عبارتند از:
- دسترسی متمرکز به رویدادهای زیرساخت
- کاهش زمان تشخیص و رفع خطا
- تحلیل ریشه ای براساس شواهد
- تشخیص رخدادهای امنیتی
- ارزیابی اثر انتشار نسخه جدید
- ایجاد سابقه ممیزی
- افزایش هماهنگی میان توسعه، عملیات و امنیت
- شناسایی الگوهای تکراری
- خودکارسازی بخشی از فرایند پاسخ به رخداد
چالش های لاگ مانیتورینگ
بدون استاندارد و مالکیت، سامانه لاگ به مخزنی گران و کم استفاده تبدیل می شود. رشد حجم، قالب ناسازگار، هشدار کاذب و داده حساس باید از آغاز طراحی مدیریت شوند.
حجم بالا و هزینه نگهداری
همه رویدادها ارزش یکسانی ندارند. تعیین سطح لاگ، حذف داده های کم ارزش، نمونه برداری آگاهانه و نگهداری چندلایه می توانند هزینه را کنترل کنند.
کاهش حجم نباید به حذف شواهد لازم برای امنیت، ممیزی یا تحلیل حادثه منجر شود.
قالب های ناسازگار و داده بدون ساختار
پیام های آزاد و نام گذاری متفاوت فیلدها، جستجو و ساخت داشبورد را دشوار می کنند.
یک قرارداد سازمانی باید نام فیلدها، قالب زمان، سطح شدت و شناسه همبستگی را مشخص کند. اعتبارسنجی این قرارداد در فرایند انتشار از ورود لاگ های ناسازگار جلوگیری می کند.
نویز و هشدار کاذب
هشدار برای هر خطا باعث خستگی تیم می شود. گروه بندی رخدادهای مشابه، آستانه پویا و اولویت بندی براساس اثر بر کاربر می توانند نویز را کاهش دهند.
هر هشدار باید مالک، شدت، شواهد و اقدام اولیه مشخص داشته باشد.
حریم خصوصی و اطلاعات حساس
رمز عبور، توکن، شماره کارت و اطلاعات هویتی نباید وارد لاگ شوند.
ماسک کردن داده در مبدا، رمزنگاری مسیر و مخزن، کنترل دسترسی مبتنی بر نقش و ثبت فعالیت کاربران از کنترل های اصلی امنیتی هستند.
ابزارهای لاگ مانیتورینگ و معیار انتخاب
ابزار مناسب باید براساس حجم داده، محیط اجرا، نیاز امنیتی، مهارت تیم، قابلیت جستجو و هزینه کل مالکیت انتخاب شود.
Elastic Stack
Elastic Stack ترکیبی انعطاف پذیر برای جمع آوری، پردازش، جستجو و نمایش لاگ ها ارائه می کند. Elasticsearch داده را ذخیره و ایندکس می کند و Kibana برای جستجو و داشبورد استفاده می شود.
این گزینه کنترل زیادی در اختیار تیم قرار می دهد، اما مدیریت ایندکس، منابع خوشه و سیاست نگهداری در مقیاس بالا اهمیت زیادی دارد.
Grafana Loki
Loki سامانه ای برای ذخیره و جستجوی لاگ است که به جای ایندکس کردن کامل متن، بیشتر بر برچسب ها تکیه می کند. این رویکرد می تواند در بعضی سناریوها هزینه ایندکس را کاهش دهد.
Loki با Grafana یکپارچه می شود و امکان مشاهده متریک و لاگ را در یک محیط فراهم می کند. انتخاب نادرست برچسب های دارای مقادیر بسیار متنوع می تواند کارایی را کاهش دهد.
برای آشنایی بیشتر با لایه نمایش و داشبورد، مقاله Grafana چیست را مطالعه کنید.
Splunk
Splunk مجموعه کاملی برای جستجو، تحلیل، امنیت و مدیریت سازمانی داده ها ارائه می کند. قابلیت های آماده و پشتیبانی سازمانی از مزایای آن هستند.
در مقابل، مدل هزینه براساس حجم ورودی باید پیش از انتخاب دقیق بررسی شود.
سرویس های ابری مدیریت شده
سرویس های بومی AWS، Azure و Google Cloud راه اندازی اولیه و اتصال به منابع همان محیط را ساده می کنند.
هزینه ذخیره و جستجو، محدودیت نگهداری، هزینه خروج داده و وابستگی به ارائه دهنده باید در تصمیم گیری بررسی شوند.
معیارهای انتخاب ابزار
هنگام انتخاب ابزار لاگ مانیتورینگ این موارد را ارزیابی کنید:
- ظرفیت پردازش در زمان اوج
- سرعت و زبان پرس و جو
- پشتیبانی از منابع موجود
- کنترل دسترسی و امنیت
- امکانات هشدار
- سیاست نگهداری
- قابلیت اجرا در محیط فعلی
- مهارت مورد نیاز تیم
- پشتیبانی و مستندات
- هزینه کل مالکیت
پیش از تصمیم نهایی، یک نمونه آزمایشی با داده واقعی اجرا کنید. سناریوهایی مانند خطای ورود، افزایش خطای API و کندی پایگاه داده می توانند برای مقایسه ابزارها استفاده شوند.
بهترین روش های پیاده سازی
سامانه لاگ زمانی ارزش ایجاد می کند که کیفیت داده و فرایند پاسخ همزمان طراحی شوند.
لاگ ساخت یافته و استاندارد
لاگ JSON با فیلدهای ثابت برای ماشین و انسان قابل تحلیل تر است. زمان، سطح شدت، نام سرویس و شناسه درخواست باید با قالب مشخص ثبت شوند.
{
  "timestamp": "2026-09-14T10:24:31Z",
  "level": "ERROR",
  "service": "payment-api",
  "environment": "production",
  "request_id": "req_7f21a9",
  "event": "payment_failed",
  "status_code": 502,
  "duration_ms": 1840,
  "message": "upstream gateway timeout"
}
پیام باید برای انسان خوانا باشد و اطلاعات قابل جستجو در فیلدهای جداگانه قرار گیرند.
شناسه همبستگی و زمینه رویداد
یک request_id یا trace_id مشترک، رویدادهای یک درخواست را میان سرویس های مختلف به هم متصل می کند.
نسخه برنامه، محیط اجرا، منطقه استقرار و نام سرویس نیز برای مقایسه رخدادها مفید هستند. شناسه کاربر باید داخلی یا ناشناس باشد و داده شخصی در لاگ قرار نگیرد.
سطح بندی، نگهداری و دسترسی
سطوح رایج لاگ عبارتند از:
DEBUG: اطلاعات جزئی برای توسعه و عیب یابیINFO: رویدادهای عادی و مهمWARN: وضعیت غیرعادی که هنوز باعث شکست نشده استERROR: شکست یک عملیاتFATAL: خطایی که ادامه اجرای سرویس را مختل می کند
دسترسی و مدت نگهداری باید براساس حساسیت و کاربرد هر گروه از داده ها تعریف شود.
هشدار قابل اقدام و Runbook
هشدار خوب باید اثر رخداد، دامنه مشکل، شواهد موجود، مالک و اقدام اولیه را مشخص کند.
اتصال هشدار به یک جستجوی آماده و Runbook زمان بررسی را کاهش می دهد. پس از هر حادثه نیز باید کیفیت هشدار و راهنمای اقدام بازبینی شود.
ارتباط لاگ مانیتورینگ با مانیتورینگ سرور
مانیتورینگ سرور معمولا وضعیت منابع و سرویس ها را با متریک هایی مانند CPU، حافظه، دیسک، شبکه و زمان پاسخ نشان می دهد. لاگ مانیتورینگ جزئیات رخدادهای پشت این تغییرات را فراهم می کند.
برای آشنایی کامل با این حوزه، راهنمای مانیتورینگ سرور چیست را مطالعه کنید.
از متریک تا علت خطا
افزایش CPU یا زمان پاسخ فقط یک نشانه است. بررسی لاگ های همان بازه زمانی می تواند فرایند، درخواست یا وابستگی ایجادکننده مشکل را مشخص کند.
همگام بودن ساعت سامانه ها و استفاده از برچسب های مشترک مانند host و service برای این ارتباط ضروری است.
Prometheus در کنار لاگ ها
Prometheus برای جمع آوری و پرس و جوی متریک های سری زمانی طراحی شده است و جای مخزن لاگ را نمی گیرد.
هشدار Prometheus می تواند نقطه آغاز بررسی باشد و تحلیلگر را به لاگ های سرویس و بازه زمانی مربوط هدایت کند.
برای آشنایی بیشتر با نقش این ابزار، مقاله Prometheus چیست را مطالعه کنید.
طراحی نمای عملیاتی یکپارچه
یک نمای عملیاتی مناسب باید شاخص سلامت، رخداد مهم، تغییرات اخیر و مسیر بررسی عمیق را کنار هم قرار دهد.
هر داشبورد باید مخاطب و پرسش مشخص داشته باشد. داشبوردهای متعدد بدون مالک و کاربرد روشن معمولا پس از مدتی کنار گذاشته می شوند.
مراحل راه اندازی لاگ مانیتورینگ
راه اندازی بهتر است با یک سرویس مهم و چند سناریوی قابل اندازه گیری آغاز شود. پس از اثبات ارزش و کنترل هزینه می توان دامنه را گسترش داد.
۱. تعیین هدف و دامنه
ابتدا سرویس، کاربران، ریسک و پرسش های عملیاتی را مشخص کنید. هدف می تواند کاهش زمان تشخیص خطای پرداخت یا شناسایی تلاش های ورود مشکوک باشد.
شاخص موفقیت، مالک پروژه و بازه آزمایش را از ابتدا تعیین کنید.
۲. شناسایی منابع لاگ
فهرستی از برنامه ها، میزبان ها، کانتینرها، پایگاه های داده، تجهیزات شبکه و سرویس های خارجی تهیه کنید.
برای هر منبع، مالک، قالب، حجم، حساسیت، محل تولید و روش دسترسی را ثبت کنید.
۳. طراحی خط لوله و انتخاب ابزار
ظرفیت اوج، تحمل خطا، بافر، رمزنگاری، پردازش و مقصد ذخیره سازی را طراحی کنید.
سلامت خود خط لوله نیز باید قابل مشاهده باشد. نرخ دریافت، تاخیر ارسال، اندازه صف و خطای پردازش نشان می دهند آیا داده به صورت کامل به مقصد رسیده است.
۴. تعریف طرح و سیاست نگهداری
فیلدهای اجباری، قالب زمان، سطح شدت و قواعد حذف اطلاعات حساس را مشخص کنید.
مدت نگهداری باید براساس ارزش عملیاتی، الزام ممیزی و هزینه تعیین شود. تغییر طرح نیز باید نسخه بندی و پیش از انتشار آزمایش شود.
۵. ساخت داشبورد، هشدار و Runbook
برای سناریوهای اصلی، جستجوهای ذخیره شده و داشبوردهای کوتاه بسازید. هشدارها را با داده تاریخی تنظیم کنید تا میزان خطای آنها مشخص شود.
Runbook باید بررسی اولیه، روش مهار، مالک سرویس و اطلاعات لازم برای ارجاع را توضیح دهد.
۶. آزمون، آموزش و بهبود مستمر
با ایجاد یک رخداد آزمایشی بررسی کنید که داده به صورت کامل دریافت می شود و تیم می تواند هشدار را تا رسیدن به علت دنبال کند.
شاخص هایی مانند زمان کشف، زمان رفع، نرخ هشدار کاذب، هزینه هر گیگابایت و پوشش منابع را به صورت دوره ای بررسی کنید.
جمع بندی
لاگ مانیتورینگ زمانی موثر است که داده ساخت یافته، خط لوله قابل اعتماد، جستجوی سریع، هشدار مناسب و فرایند پاسخ را به هم متصل کند.
شروع با دامنه کوچک، حذف اطلاعات حساس، تعریف سیاست نگهداری و اتصال لاگ به Metric و Trace، ریسک و هزینه اجرای پروژه را کاهش می دهد. پس از سنجش نتیجه می توان این الگو را به سایر سرویس ها گسترش داد.
سوالات متداول درباره لاگ مانیتورینگ
لاگ مانیتورینگ چیست و چه تفاوتی با نگهداری لاگ دارد؟
نگهداری فقط حفظ داده است؛ لاگ مانیتورینگ جمع آوری، جستجو، تحلیل و هشدار را برای تشخیص و پاسخ به رخداد به هم متصل می کند.
برای لاگ مانیتورینگ از چه ابزاری استفاده کنیم؟
انتخاب به حجم، محیط اجرا، مهارت تیم، امنیت و بودجه بستگی دارد. Elastic Stack، Grafana Loki، Splunk و سرویس های ابری گزینه های رایج هستند.
لاگ ها چه مدت نگهداری شوند؟
مدت عمومی ثابتی وجود ندارد. ارزش عملیاتی، الزام ممیزی، حساسیت داده و هزینه برای هر نوع لاگ سنجیده می شود.
آیا ثبت لاگ می تواند خطر امنیتی ایجاد کند؟
بله، اگر توکن، رمز یا داده شخصی ثبت شود. ماسک در مبدا، رمزنگاری، کنترل نقش و ثبت فعالیت کاربران ضروری است.
آیا لاگ مانیتورینگ جای مانیتورینگ سرور را می گیرد؟
خیر. متریک سرور نشانه و روند را نشان می دهد و لاگ جزئیات رخداد را ارائه می کند. ترکیب آنها مسیر رسیدن به علت را کوتاه می کند.
چطور هزینه لاگ مانیتورینگ را کنترل کنیم؟
سطح ثبت، حذف نویز، نگهداری چندلایه، فشرده سازی و پایش حجم ورودی موثر است؛ بدون آنکه شواهد ضروری حذف شوند.
برای طراحی مانیتورینگ یکپارچه آماده اید؟
برای پیاده سازی سامانه پایش متناسب با معماری و نیازهای عملیاتی زیرساخت، می توانید با تیم سربروس در ارتباط باشید.