وقتی یک سایت یا برنامه فقط به یک سرور وابسته باشد، خرابی همان سرور می تواند دسترسی کاربران را متوقف کند. اما اگر چند سرور داشته باشیم، آیا سرویس همیشه در دسترس می ماند؟ پاسخ به نحوه طراحی کل زیرساخت بستگی دارد؛ زیرا پایگاه داده، شبکه یا حتی ابزار توزیع ترافیک نیز ممکن است به نقطه شکست تبدیل شوند.
High Availability یا دسترس پذیری بالا، رویکردی برای کاهش احتمال و مدت اختلال در سرویس است. در این مقاله بررسی می کنیم HA چیست، چگونه کار می کند و معماری های مختلف آن چه تفاوت هایی دارند.
خلاصه سریع
• High Availability یا HA رویکردی برای کاهش احتمال و مدت اختلال سرویس و حفظ دسترس پذیری مورد نیاز کاربران است.
• افزونگی، بررسی سلامت، Failover و مدیریت داده از سازوکارهای اصلی آن هستند.
• داشتن چند سرور کافی نیست؛ وابستگی های ضروری و نقاط شکست واحد نیز باید بررسی شوند.
• Active-Active و Active-Passive دو الگوی رایج هستند و انتخاب آنها به نیاز سرویس بستگی دارد.
• HA به معنی قطعی صفر نیست؛ هدف دسترس پذیری باید با معیار و بازه اندازه گیری مشخص تعریف شود.
• لود بالانسینگ می تواند بخشی از HA باشد، اما HA جایگزین بکاپ و بازیابی بحران نیست.
• ظرفیت پس از خرابی و عملکرد Failover باید در آزمون واقعی تایید شوند.
High Availability چیست و چه کاربردی دارد؟
High Availability یا دسترس پذیری بالا، به طراحی و بهره برداری از سیستم به شکلی گفته می شود که سرویس در بازه مورد انتظار، با کمترین اختلال ممکن در دسترس کاربران باقی بماند. این هدف با ترکیبی از افزونگی، تشخیص خرابی، انتقال سرویس به منابع سالم و مدیریت وابستگی ها دنبال می شود.
مخفف High Availability، عبارت HA است. دسترس پذیری در اینجا فقط به روشن بودن سرور اشاره ندارد؛ کاربر باید بتواند عملکرد مورد نیاز خود را با کیفیت قابل قبول انجام دهد. برای مثال، اگر صفحه فروشگاه باز شود اما ثبت سفارش به دلیل خرابی پایگاه داده امکان پذیر نباشد، سرویس خرید از دید مشتری در دسترس نیست.
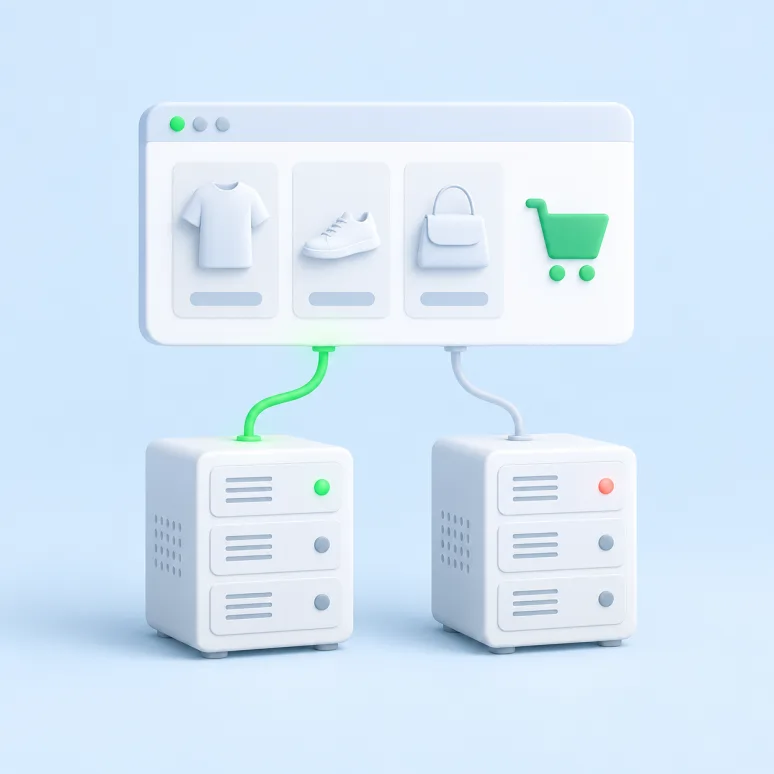
در یک فروشگاه اینترنتی که برنامه آن روی یک سرور اجرا می شود، خرابی سرور می تواند فروش را متوقف کند. در معماری دارای دسترس پذیری بالا، نمونه دیگری از برنامه آماده پاسخگویی است و درخواست های جدید می توانند به آن هدایت شوند. البته این طراحی زمانی موثر است که وابستگی های ضروری، مانند پایگاه داده و مسیر ورود ترافیک، نیز متناسب با همان هدف طراحی شده باشند.
HA به معنی تضمین قطعی صفر یا دسترس پذیری صددرصدی نیست. تشخیص خرابی و جابه جایی سرویس ممکن است زمان ببرد و بعضی درخواست های در حال اجرا نیز با خطا مواجه شوند. هدف، محدود کردن این اختلال و رسیدن به سطح دسترس پذیری مورد نیاز کسب و کار است.
این رویکرد برای فروشگاه های اینترنتی، سامانه های پرداخت، نرم افزارهای سازمانی، سرویس های اشتراکی و برنامه هایی اهمیت بیشتری دارد که توقف آنها مستقیما به درآمد یا فعالیت کاربران آسیب می زند. با این حال، سطح مناسب HA برای همه پروژه ها یکسان نیست. هزینه قطعی، ساعات مورد انتظار فعالیت، بودجه و توان تیم عملیاتی باید در انتخاب راهکار در نظر گرفته شوند.
High Availability چگونه کار می کند؟
دسترس پذیری بالا حاصل اضافه کردن یک سرور دوم به تنهایی نیست. اجزای سیستم باید بتوانند خرابی را تشخیص دهند، سرویس را روی منابع سالم ادامه دهند و داده های مورد نیاز را در اختیار آن منابع قرار دهند. سازوکارهای زیر در کنار یکدیگر این امکان را فراهم می کنند.
افزونگی و حذف نقاط شکست واحد
افزونگی یا Redundancy یعنی برای اجزای ضروری سیستم، منابع جایگزین یا موازی در نظر گرفته شود. برای مثال، به جای اجرای برنامه روی یک سرور، می توان چند نمونه از آن را روی سرورهای جداگانه اجرا کرد.
اما وجود چند نمونه فقط زمانی مفید است که همه آنها به یک عامل مشترک آسیب پذیر وابسته نباشند. دو سرور روی یک میزبان فیزیکی، در برابر خرابی همان میزبان محافظت کافی ایجاد نمی کنند. به همین ترتیب، چند سرور برنامه که همگی به یک پایگاه داده بدون جایگزین متصل هستند، همچنان یک وابستگی بحرانی مشترک دارند.
نقطه شکست واحد یا Single Point of Failure، جزئی است که خرابی آن می تواند عملکرد سرویس را متوقف کند. این جزء ممکن است سرور، پایگاه داده، تجهیزات شبکه، فضای ذخیره سازی یا یک سرویس خارجی ضروری باشد.
در طراحی HA باید این نقاط شناسایی شوند و برای خرابی آنها راهکار متناسب در نظر گرفته شود. جداسازی منابع میان میزبان ها یا نواحی مستقل نیز کمک می کند یک خرابی مشترک، تمام نمونه ها را همزمان از دسترس خارج نکند.
بررسی سلامت و تشخیص خرابی
سیستم برای هدایت درخواست ها به منابع سالم، باید بداند کدام نمونه واقعا آماده پاسخگویی است. Health Check یا بررسی سلامت، وضعیت یک سرور یا برنامه را براساس معیارهای مشخص ارزیابی می کند.
این بررسی نباید همیشه به روشن بودن سرور یا باز بودن یک پورت محدود شود. ممکن است برنامه اجرا شده باشد، اما به دلیل خطای داخلی یا قطع ارتباط با یک وابستگی ضروری، نتواند درخواست کاربران را انجام دهد. معیار سلامت باید با وظیفه واقعی سرویس هماهنگ باشد.
تنظیم این بررسی ها نیز اهمیت دارد. بررسی بیش از حد حساس ممکن است یک کندی کوتاه را خرابی تلقی کند و باعث جابه جایی های غیرضروری شود. بررسی بیش از حد کند نیز مدت ارسال درخواست به نمونه خراب را افزایش می دهد.
مانیتورینگ سرور و هشداردهی در کنار بررسی سلامت کمک می کنند تیم فنی از خرابی ها، کاهش ظرفیت و مشکلاتی که با انتقال ترافیک برطرف نمی شوند مطلع شود.
انتقال سرویس با Failover
Failover فرایند انتقال نقش یا ترافیک از جزء خراب به جزء سالم یا آماده جایگزینی است. برای مثال، اگر سرور اصلی از دسترس خارج شود، سیستم می تواند درخواست های جدید را به سرور دیگری بفرستد یا یک نمونه آماده را به عنوان سرور اصلی فعال کند.
این انتقال ممکن است خودکار یا با دخالت تیم فنی انجام شود. Failover خودکار معمولا زمان واکنش را کاهش می دهد، اما موفقیت آن به تشخیص درست خرابی، آماده بودن مقصد و تنظیم صحیح اجزای مرتبط بستگی دارد.
انتقال ترافیک نیز لزوما درخواست های قبلی را نجات نمی دهد. اتصالی که هنگام خرابی قطع شده، ممکن است نیاز به برقراری دوباره داشته باشد. در عملیات حساس مانند پرداخت یا ثبت سفارش، برنامه باید طوری طراحی شود که تلاش مجدد به ثبت تکراری عملیات منجر نشود.
پس از رفع خرابی، بازگرداندن نقش یا ترافیک به جزء اولیه نیز باید برنامه مشخصی داشته باشد. این بازگشت که Failback نامیده می شود، نباید بدون بررسی سلامت و هماهنگی داده ها انجام شود.
تکثیر داده و مدیریت وضعیت برنامه
ادامه سرویس روی سرور جایگزین، به دسترسی آن سرور به داده های مورد نیاز بستگی دارد. Replication یا تکثیر داده، تغییرات داده را میان چند نمونه منتقل می کند تا در صورت خرابی یک نمونه، نسخه دیگری قابل استفاده باشد.
در تکثیر همزمان، تایید عملیات می تواند به ثبت تغییر در نسخه دیگری نیز وابسته باشد. این روش در طراحی مناسب، خطر از دست رفتن تغییرات تاییدشده را کاهش می دهد، اما ممکن است تاخیر عملیات را افزایش دهد.
در تکثیر غیرهمزمان، تغییرات با فاصله زمانی به نسخه دیگر منتقل می شوند. اگر خرابی پیش از انتقال آخرین تغییرات رخ دهد، ممکن است نسخه جایگزین بخشی از داده های جدید را نداشته باشد. بنابراین انتخاب روش تکثیر به نیاز برنامه و میزان قابل قبول تاخیر یا از دست رفتن داده بستگی دارد.
وضعیت برنامه نیز باید بررسی شود. اگر نشست کاربر یا فایل ضروری فقط روی سرور خراب ذخیره شده باشد، انتقال درخواست به سرور سالم برای ادامه کار کافی نیست. منابع جایگزین باید بتوانند به وضعیت لازم دسترسی داشته باشند یا آن را به شکل قابل اطمینان بازسازی کنند.
تکثیر داده جایگزین بکاپ نیست. حذف اشتباه یا تغییر مخرب داده ممکن است به نسخه های دیگر نیز منتقل شود؛ به همین دلیل، پشتیبان گیری و امکان بازیابی همچنان ضروری هستند.
معماری High Availability چه مدل هایی دارد؟
دو الگوی رایج در معماری دسترس پذیری بالا، Active-Active و Active-Passive هستند. تفاوت اصلی آنها در این است که منابع جایگزین هنگام فعالیت عادی سیستم چه نقشی دارند.
این الگوها می توانند برای یک لایه مشخص، مانند برنامه یا پایگاه داده، به کار بروند. بنابراین یک سیستم ممکن است در لایه برنامه Active-Active و در لایه پایگاه داده Active-Passive باشد.
معماری Active-Active
در معماری Active-Active، چند نمونه به صورت همزمان درخواست ها را پردازش می کنند. برای مثال، دو سرور برنامه پشت یک لود بالانسر قرار می گیرند و هر دو در پاسخگویی به کاربران مشارکت دارند.
اگر یکی از نمونه ها خراب شود، پس از تشخیص خرابی، درخواست های جدید به نمونه های سالم هدایت می شوند. این ساختار علاوه بر کمک به دسترس پذیری، می تواند توزیع بار میان منابع را نیز فراهم کند.
با این حال، ظرفیت باقی مانده باید برای شرایط خرابی کافی باشد. اگر هر دو سرور در حالت عادی نزدیک به حداکثر ظرفیت کار کنند، خارج شدن یکی از آنها ممکن است سرور دیگر را نیز تحت فشار قرار دهد و باعث اختلال گسترده تر شود.
مدیریت داده و وضعیت برنامه نیز اهمیت دارد. فعال بودن همزمان چند سرور برنامه به معنی امکان نوشتن همزمان روی چند پایگاه داده مستقل نیست. طراحی Active-Active در لایه داده می تواند به هماهنگی پیچیده تری برای جلوگیری از تعارض نیاز داشته باشد.
معماری Active-Passive
در معماری Active-Passive، یک نمونه نقش اصلی پاسخگویی را دارد و نمونه دیگری برای جایگزینی آن آماده نگه داشته می شود. نمونه آماده معمولا ترافیک اصلی کاربران را دریافت نمی کند، اما ممکن است داده ها را تکثیر کند یا وظایف جانبی داشته باشد.
برای مثال، یک پایگاه داده اصلی عملیات برنامه را انجام می دهد و تغییرات به نمونه آماده منتقل می شوند. در صورت خرابی نمونه اصلی، نمونه آماده می تواند طبق فرایند مشخص به نقش اصلی ارتقا پیدا کند.
زمان ادامه سرویس به میزان آمادگی نمونه جایگزین، وضعیت داده ها، تشخیص خرابی و مراحل فعال سازی بستگی دارد. اگر منابع جایگزین از قبل اجرا و هماهنگ باشند، انتقال معمولا سریع تر از حالتی است که ابتدا باید منابع ساخته یا داده ها بازیابی شوند.
در این الگو باید از فعال شدن همزمان و کنترل نشده دو نمونه اصلی جلوگیری شود. چنین وضعیتی که Split-Brain نامیده می شود، می تواند به تغییرات متعارض و ناسازگاری داده منجر شود.
مقایسه Active-Active و Active-Passive
| ویژگی | Active-Active | Active-Passive |
|---|---|---|
| پاسخگویی در حالت عادی | چند نمونه همزمان پاسخ می دهند. | نمونه اصلی پاسخ می دهد و نمونه جایگزین آماده است. |
| استفاده از ظرفیت | منابع فعال در پردازش بار مشارکت دارند. | بخشی از ظرفیت برای زمان خرابی نگه داشته می شود. |
| واکنش به خرابی | ترافیک از نمونه خراب به نمونه های سالم هدایت می شود. | نقش اصلی به نمونه آماده منتقل می شود. |
| شرط مهم برای ادامه سرویس | ظرفیت کافی منابع باقی مانده و مدیریت وضعیت برنامه. | آمادگی مقصد، هماهنگی داده و کنترل انتقال نقش. |
| پیچیدگی در لایه داده | نوشتن همزمان روی چند نمونه می تواند پیچیده باشد. | کنترل نقش اصلی و جلوگیری از Split-Brain اهمیت دارد. |
هیچ کدام از این دو الگو برای همه پروژه ها بهترین انتخاب نیست. تصمیم باید براساس مدت اختلال قابل قبول، نیازهای داده، ظرفیت مورد نیاز پس از خرابی و توان نگهداری تیم فنی گرفته شود.
در هر دو مدل، آماده بودن معماری باید با آزمون واقعی خرابی بررسی شود. وجود سرور جایگزین روی کاغذ کافی نیست؛ باید مشخص باشد هنگام قطع یک جزء، سرویس چگونه ادامه پیدا می کند و کاربران چه اختلالی را تجربه خواهند کرد.
درصد دسترس پذیری چگونه محاسبه می شود؟
درصد دسترس پذیری نشان می دهد سرویس در چه سهمی از بازه اندازه گیری، طبق معیار تعیین شده قابل استفاده بوده است. برای محاسبه براساس زمان، مدت در دسترس بودن سرویس را بر کل زمان مورد بررسی تقسیم می کنیم و نتیجه را در ۱۰۰ ضرب می کنیم.
برای مثال، اگر یک سرویس در یک بازه ۳۰ روزه مجموعا ۴۳٫۲ دقیقه از دسترس خارج شود، دسترس پذیری زمانی آن در همان بازه برابر با ۹۹٫۹٪ خواهد بود. این محاسبه زمانی معتبر است که تعریف قطعی و روش اندازه گیری از قبل مشخص شده باشند.
درصدهای دسترس پذیری چه میزان قطعی را نشان می دهند؟
جدول زیر معادل زمانی چند سطح دسترس پذیری را نشان می دهد. محاسبات براساس فعالیت شبانه روزی، ماه ۳۰ روزه و سال ۳۶۵ روزه انجام شده اند و اعداد گرد شده اند.
| درصد دسترس پذیری | معادل قطعی در ماه ۳۰ روزه | معادل قطعی در سال ۳۶۵ روزه |
|---|---|---|
| ۹۹٪ | ۷ ساعت و ۱۲ دقیقه | ۳ روز و ۱۵ ساعت و ۳۶ دقیقه |
| ۹۹٫۹٪ | ۴۳ دقیقه و ۱۲ ثانیه | ۸ ساعت و ۴۵ دقیقه و ۳۶ ثانیه |
| ۹۹٫۹۹٪ | حدود ۴ دقیقه و ۱۹ ثانیه | حدود ۵۲ دقیقه و ۳۴ ثانیه |
| ۹۹٫۹۹۹٪ | حدود ۲۶ ثانیه | حدود ۵ دقیقه و ۱۵ ثانیه |
۹۹٫۹۹۹٪ که با عنوان Five Nines شناخته می شود، الزام ثابت برای همه سیستم های HA نیست. رسیدن به چنین هدفی به معماری، کیفیت عملیات، وابستگی ها و هزینه قابل توجهی نیاز دارد. برای بسیاری از پروژه ها، هدف پایین تر اما قابل اندازه گیری و قابل نگهداری، انتخاب مناسب تری است.
همچنین هدف ماهانه و سالانه یکسان نیستند. ممکن است یک سرویس در مجموع سال به هدف تعیین شده برسد، اما در یک ماه خاص اختلال بیشتری از حد هدف ماهانه داشته باشد. بازه ارزیابی باید همراه با درصد دسترس پذیری ذکر شود.
تفاوت اندازه گیری واقعی با تعهد SLA
SLA یا توافق نامه سطح خدمت، شرایط تعهد ارائه دهنده سرویس را مشخص می کند. این شرایط می تواند شامل درصد دسترس پذیری، بازه محاسبه، موارد استثنا و نحوه جبران نقض تعهد باشد.
بنابراین، عدد درج شده در SLA به تنهایی کافی نیست. باید بررسی شود قطعی چگونه تعریف شده، نگهداری برنامه ریزی شده چه وضعیتی دارد و اختلال در کدام بخش از سرویس محاسبه می شود.
در مقابل، SLO یا هدف سطح خدمت، هدف مشخصی برای کیفیت عملکرد سرویس است که تیم می تواند آن را براساس شاخص های اندازه گیری شده دنبال کند. برای مثال، هدف ممکن است این باشد که درصد مشخصی از درخواست های ثبت سفارش با موفقیت و در زمان قابل قبول انجام شوند.
اندازه گیری دسترس پذیری همیشه فقط زمانی نیست. در بعضی سرویس ها، نسبت درخواست های موفق به کل درخواست های معتبر، تصویر دقیق تری از تجربه کاربران ارائه می دهد. معیار انتخابی باید بتواند اختلال جزئی را نیز نشان دهد؛ مثلا زمانی که فقط بخشی از کاربران قادر به پرداخت نیستند.
دسترس پذیری زیرساخت ابری نیز به تنهایی دسترس پذیری کل برنامه را تضمین نمی کند. خطای نرم افزار، تنظیمات نادرست یا خرابی یک وابستگی ضروری می تواند سرویس کاربران را متوقف کند، حتی اگر سرورها همچنان فعال باشند.
تفاوت HA با راهکارهای مرتبط چیست؟
High Availability با لود بالانسینگ، تحمل خطا، پشتیبان گیری و بازیابی بحران ارتباط دارد، اما هر کدام وظیفه متفاوتی دارند. شناخت این تفاوت ها کمک می کند یک قابلیت محدود را با دسترس پذیری کل سیستم اشتباه نگیریم.
| مفهوم | هدف اصلی | ارتباط با High Availability |
|---|---|---|
| High Availability | کاهش احتمال و مدت اختلال سرویس. | هدفی برای طراحی و بهره برداری کل سیستم است. |
| Load Balancing | توزیع درخواست ها میان چند مقصد. | می تواند ترافیک را به مقصدهای سالم هدایت کند و بخشی از معماری HA باشد. |
| Fault Tolerance | ادامه عملکرد هنگام خرابی اجزای مشخص، در محدوده طراحی. | رویکردی برای حفظ سرویس در برابر خرابی است؛ میزان اختلال قابل قبول باید مشخص باشد. |
| Backup | نگهداری نسخه ای قابل بازیابی از داده ها. | برای بازیابی داده ضروری است، اما سرویس جایگزین آماده ایجاد نمی کند. |
| Disaster Recovery | بازیابی سرویس و داده پس از اختلال شدید. | مکمل HA برای سناریوهایی است که نیاز به بازیابی گسترده دارند. |
تفاوت High Availability و Load Balancing
لود بالانسینگ به توزیع بار مربوط است؛ High Availability به در دسترس ماندن سرویس. یک لود بالانسر می تواند درخواست ها را میان چند سرور تقسیم کند و با بررسی سلامت، مقصد خراب را از چرخه پاسخگویی خارج کند.
اما اگر خود لود بالانسر تنها نقطه ورود و بدون جایگزین باشد، خرابی آن می تواند دسترسی به همه سرورهای پشت آن را قطع کند. به همین ترتیب، چند سرور برنامه پشت لود بالانسر، مشکل یک پایگاه داده مشترک و بدون جایگزین را برطرف نمی کنند.
از طرف دیگر، بعضی معماری های HA با انتقال نقش میان نمونه اصلی و آماده کار می کنند و برای همان لایه، به توزیع همزمان بار نیاز ندارند. بنابراین لود بالانسر می تواند ابزار مهمی در معماری HA باشد، اما وجود آن به تنهایی اثبات کننده دسترس پذیری بالا نیست.
تفاوت High Availability و Fault Tolerance
Fault Tolerance یا تحمل خطا، توانایی سیستم برای ادامه عملکرد هنگام خرابی اجزای مشخص است. این توانایی باید در برابر سناریوهای تعریف شده بررسی شود؛ مانند خرابی یک سرور، دیسک یا مسیر شبکه.
در کاربرد رایج، معماری HA ممکن است برای ادامه سرویس به تشخیص خرابی و Failover نیاز داشته باشد و در این فاصله، اختلال کوتاهی ایجاد شود. طراحی تحمل خطا می تواند برای حفظ عملکرد با اختلال کمتر یا بدون وقفه محسوس در همان سناریوی خرابی در نظر گرفته شود.
با این حال، مرز این اصطلاحات در همه منابع و محصولات کاملا یکسان نیست. هنگام انتخاب راهکار، باید به جای اتکا به نام آن، پرسید: کدام خرابی پوشش داده می شود، انتقال چقدر زمان می برد و چه اتفاقی برای درخواست ها و داده های در حال پردازش می افتد؟
تفاوت High Availability، بکاپ و Disaster Recovery
HA عمدتا برای ادامه سرویس در برابر خرابی های پیش بینی شده طراحی می شود؛ بکاپ برای بازیابی داده و Disaster Recovery برای بازگرداندن سرویس پس از اختلال شدید کاربرد دارد.
برای مثال، خرابی یک سرور برنامه ممکن است با انتقال ترافیک به سرور سالم مدیریت شود. اما حذف اشتباه اطلاعات مشتریان می تواند به نسخه های تکثیرشده نیز منتقل شود. در این حالت، وجود چند نمونه فعال لزوما کمکی به بازگرداندن داده نمی کند و نسخه پشتیبان قابل بازیابی اهمیت پیدا می کند.
در سناریویی مانند از دسترس خارج شدن یک مرکز داده، ممکن است لازم باشد سرویس در محل دیگری فعال شود یا از نسخه های پشتیبان بازیابی شود. چنین اقداماتی باید در برنامه بازیابی بحران تعریف و آزمایش شده باشند.
دو شاخص مهم در این برنامه عبارت اند از:
- RTO: هدف زمانی برای بازگرداندن سرویس پس از اختلال.
- RPO: هدف مربوط به میزان قابل قبول از دست رفتن داده، بیان شده به صورت فاصله زمانی.
برای نمونه، RPO برابر با ۱۵ دقیقه یعنی هدف این است که در سناریوی مورد نظر، بیش از ۱۵ دقیقه از آخرین تغییرات داده از دست نرود. رسیدن به این هدف به روش پشتیبان گیری یا تکثیر و نتیجه آزمون های بازیابی بستگی دارد.
برای پیاده سازی High Availability چه نکاتی مهم است؟
انتخاب ابزار باید پس از مشخص شدن نیاز سرویس انجام شود. معماری مناسب برای یک سایت اطلاع رسانی ممکن است با سامانه پرداخت یا نرم افزار سازمانی تفاوت زیادی داشته باشد. هدف، ساخت زیرساختی است که سطح دسترس پذیری مورد نیاز را با هزینه و پیچیدگی قابل مدیریت فراهم کند.
نیاز کسب و کار و وابستگی های ضروری را مشخص کنید
ابتدا مشخص کنید کدام عملکردها باید در دسترس بمانند و توقف آنها چه پیامدی دارد. باز شدن صفحه اصلی، ورود کاربر و ثبت سفارش سه عملکرد متفاوت هستند و ممکن است به اجزای مختلفی وابسته باشند.
سپس مسیر انجام هر عملکرد ضروری را بررسی کنید. DNS، شبکه، لود بالانسر، برنامه، پایگاه داده، فضای ذخیره سازی و سرویس های خارجی می توانند در این مسیر نقش داشته باشند.
افزایش تعداد سرورهای برنامه، خرابی وابستگی مشترک آنها را حل نمی کند. برای هر وابستگی ضروری باید مشخص باشد چه خرابی هایی پوشش داده می شوند و در صورت اختلال، آیا ادامه محدود سرویس امکان پذیر است یا خیر.
ظرفیت باقی مانده و وضعیت داده را بررسی کنید
منابع سالم باید پس از خارج شدن یک جزء، ظرفیت کافی برای بار مورد انتظار داشته باشند. ظرفیت لازم را باید در شرایط خرابی سنجید، نه فقط زمانی که همه منابع فعال هستند.
اگر ادامه کار به افزایش خودکار منابع وابسته است، زمان ساخت و آماده شدن آنها نیز باید در نظر گرفته شود. ممکن است سرویس پیش از اضافه شدن ظرفیت جدید، با کندی یا خطا مواجه شود.
در لایه داده، روش تکثیر، تاخیر نسخه ها و شرایط انتقال نقش باید روشن باشد. نشست کاربران، فایل های بارگذاری شده و عملیات در حال اجرا نیز باید بررسی شوند تا جابه جایی میان سرورها به خروج ناخواسته کاربران یا ناسازگاری اطلاعات منجر نشود.
Failover و بازیابی را در عمل آزمایش کنید
وجود نمونه جایگزین زمانی ارزش دارد که انتقال به آن در شرایط واقعی کار کند. آزمون کنترل شده باید نشان دهد قطع یک سرور یا وابستگی چه اثری بر سرویس دارد و سیستم چگونه واکنش نشان می دهد.
در این آزمون ها، زمان تشخیص خرابی، مدت انتقال، خطاهای کاربران، ظرفیت مقصد و وضعیت داده اندازه گیری می شوند. بازگشت به حالت عادی نیز باید بررسی شود تا رفع خرابی به اختلال تازه ای منجر نشود.
آزمون بازیابی بکاپ باید جداگانه انجام شود. موفق بودن عملیات پشتیبان گیری، به تنهایی ثابت نمی کند که داده ها در زمان مورد نیاز و به شکل قابل استفاده بازیابی خواهند شد.
پایش، نگهداری و هزینه را بخشی از معماری بدانید
معماری HA به نگهداری مداوم نیاز دارد. هشدارهای قابل اقدام، پایش تجربه واقعی کاربران، مستندات عملیات و مسئولیت مشخص تیم، به اندازه منابع جایگزین اهمیت دارند.
تغییر تنظیمات و انتشار نسخه جدید نیز می تواند باعث اختلال شود. روش استقرار، بررسی سلامت نسخه جدید و امکان بازگشت باید با هدف دسترس پذیری هماهنگ باشند.
هزینه فقط شامل سرور دوم نیست. منابع آماده، تکثیر داده، انتقال شبکه، ابزارهای پایش و زمان تیم عملیاتی نیز بخشی از هزینه هستند. معماری پیچیده ای که تیم توان نگهداری آن را ندارد، می تواند خود به منبع خطا تبدیل شود.
پیش از انتخاب راهکار، این پرسش ها باید پاسخ مشخص داشته باشند:
- چه عملکردهایی باید در چه ساعاتی در دسترس باشند؟
- چه میزان اختلال و از دست رفتن داده قابل قبول است؟
- کدام اجزا نقطه شکست واحد هستند؟
- پس از خرابی یک جزء، ظرفیت کافی باقی می ماند؟
- زمان Failover و بازیابی در آزمون واقعی چقدر بوده است؟
- چه کسی مسئول دریافت هشدار و مدیریت اختلال است؟
جمع بندی: High Availability یک هدف قابل اندازه گیری است
High Availability رویکردی برای کاهش احتمال و مدت اختلال سرویس است. افزونگی، بررسی سلامت، Failover، مدیریت داده و حذف نقاط شکست واحد، اجزای اصلی این رویکرد هستند؛ اما هیچ کدام به تنهایی دسترس پذیری کل سیستم را تضمین نمی کنند.
انتخاب میان Active-Active و Active-Passive باید با نیاز کسب و کار، ظرفیت لازم و شرایط داده هماهنگ باشد. نتیجه نیز باید از دید کاربر اندازه گیری و با آزمون خرابی تایید شود. معماری مناسب، معماری ای است که هدف دسترس پذیری مشخصی داشته باشد و تیم بتواند آن را در عمل حفظ کند.
زیرساخت شما در زمان خرابی چگونه به کار ادامه می دهد؟
اگر ادامه فعالیت سایت یا برنامه شما به یک سرور یا پایگاه داده وابسته است، بررسی نقاط شکست واحد، ظرفیت منابع جایگزین و روش بازیابی می تواند قدم بعدی باشد. برای بررسی نیازهای دسترس پذیری زیرساخت و انتخاب راهکار متناسب با کسب و کارتان، از طریق خدمات دواپس سربروس با ما در ارتباط باشید.
سوالات متداول درباره High Availability
آیا High Availability به معنی قطعی صفر است؟
خیر. HA برای کاهش احتمال و مدت اختلال طراحی می شود. تشخیص خرابی، انتقال نقش و برقراری دوباره اتصال ها ممکن است وقفه ایجاد کند. میزان این وقفه به معماری و سناریوی خرابی بستگی دارد.
آیا داشتن دو سرور برای HA کافی است؟
خیر. اگر هر دو سرور به یک پایگاه داده، میزبان فیزیکی یا مسیر شبکه بدون جایگزین وابسته باشند، همان وابستگی می تواند کل سرویس را متوقف کند. بررسی نقاط شکست واحد ضروری است.
آیا لود بالانسر همان High Availability است؟
خیر. لود بالانسر درخواست ها را میان مقصدها توزیع می کند و می تواند بخشی از معماری HA باشد. برای دسترس پذیری بالا، پایداری خود لود بالانسر و سایر وابستگی های سرویس نیز باید بررسی شود.
آیا Kubernetes به تنهایی دسترس پذیری بالا ایجاد می کند؟
خیر. Kubernetes می تواند به اجرای چند نمونه، جایگزینی نمونه های خراب و مدیریت برنامه کمک کند. اما دسترس پذیری کل سرویس به طراحی کلاستر، ظرفیت، ذخیره سازی، پایگاه داده، شبکه و تنظیمات برنامه نیز وابسته است.
آیا در معماری HA همچنان به بکاپ نیاز داریم؟
بله. تکثیر داده می تواند حذف اشتباه یا تغییر مخرب را به نسخه های دیگر منتقل کند. بکاپ قابل بازیابی برای سناریوهای از دست رفتن یا خراب شدن داده همچنان ضروری است.